临床人工智能与机器学习指标入门:如何评估兽医临床实践中的AI工具

临床人工智能与机器学习指标入门:如何评估兽医临床实践中的人工智能工具
Brian Hur, DVM, PhD, Aparna Elangovan, PhD, Laura Hardefeldt, BScBVMS, MPH, PhD
关键词
- 人工智能
- 机器学习
- 兽医医学
- 性能指标
- 模型验证
- 外部验证
- 诊断 AI
- 临床决策支持
要点
- 评估人工智能(AI)工具需要理解核心性能指标,并认识到报告的性能在很大程度上取决于所测试的人群。
- AI 性能从根本上受专家标注者之间标注者间一致性的限制,这一概念在验证研究中经常被忽视,它设定了模型评估的上限。
- 在独立数据集上进行外部验证至关重要,因为 AI 工具在原始训练环境之外部署时经常因域偏移而出现性能下降。
- 在兽医 AI 缺乏监管的情况下,临床医生有责任在采用前使用标准化评估框架严格评价工具。
引言
过去几年,人工智能(AI)和机器学习(ML)在兽医医学中的应用明显加速,工具现已部署在各种临床应用中[1–3]。这些应用包括自动生成病历的环境记录工具、分析 X 光片和病理切片的计算机视觉系统,以及从数百万份问诊记录中提取结构化数据的自然语言处理流程[4–7]。开发步伐没有放缓的迹象;随着推动临床应用的同一 AI 技术现在可以协助自身开发,创建此类工具的门槛持续降低[8]。
AI 开发门槛的降低既赋权又危险[9]。正如我们在兽医行业中特别重视评估其他新疗法一样,我们也需要了解如何评估基于 AI 和 ML 的工具。应用或构建此类工具时,应理解评估中的差异[10]。早期开发工具需要编程能力和对 ML 的深入理解;然而,推动 AI 的同一基础模型现在可以帮助开发使用 AI 的系统本身。这可能导致缺乏或没有编程经验的创作者大量制作工具[11,12]。虽然这些 AI 和 ML 工具有用,但其价值可能被夸大,如果评估不当甚至可能有害。所有参与其使用的人都必须了解用于评估的机制[13,14]。
兽医领域在许多方面具有独特性,给 AI 工具评估带来挑战[1,15]。物种差异、与人医相比有限的测试数据构建的 AI 工具、以及多样化的实践环境(小动物、大动物、 exotic 和急诊)都带来重大问题[16]。此外,该领域通常比人医监管更少,在许多地区没有管理委员会控制个体兽医如何使用 AI 工具[17,18]。在一种环境(如大学教学医院)中评估的 AI 工具,在另一种环境(如普通全科诊所)中测试时,由于环境和工作流程的诸多差异,性能可能大幅下降,这通常被称为域偏移[19,20]。人医中一个广泛部署的脓毒症预测算法在独立外部验证中就明显证明了这一点,其性能与开发者报告的指标相比大幅下降,同时漏诊了大多数实际脓毒症病例[21]。
兽医界将从在诊所使用 AI 工具中受益,包括改善与患者的沟通时间、简化病历记录、降低从业者倦怠风险[22–24]。此外,它可以通过允许基于群体的研究而非依赖手动评估相对少量的临床记录来扩展研究能力[25]。它还有潜力评估纵向记录,以更好地理解治疗如何影响患者结局[26]。
本文旨在为兽医医学中评估 AI 和 ML 工具提供实用框架,既适用于评估商业产品以供采用的临床医生,也适用于开发新应用的人员。目的是为兽医专业人员(无论技术背景如何)提供知情决策所需的概念基础和实用启发法。该框架涵盖当前兽医实践中部署的主要 AI 模态:病历记录工具、诊断影像、病理和细胞学、牙科放射学以及心脏病学应用。贯穿全文,我们强调评估不是一次性事件,而是从初始评估到真实世界部署和监测的持续过程。
背景
兽医医学为 AI 开发提供了独特背景,面临三个根本挑战:跨物种和品种的生物异质性、数据稀缺和质量问题、以及缺乏监管监督。我们逐一讨论。
物种与品种挑战
物种、品种和个体患者之间存在解剖和生理多样性[27,28]。在犬胸部 X 光片上检测心脏增大需要考虑胸廓形态,桶状胸的斗牛犬、深窄胸廓的灵缇犬和龙骨状胸廓的大丹犬各自代表不同的正常解剖。声称能"检测心脏病"的模型必须指定其目标人群——所有犬 vs 特定品种 vs 猫。这一挑战跨物种叠加。在犬数据上训练的 AI 系统不能直接迁移到猫,即使是同一疾病[29]。肺炎的 X 光表现、猫和马之间存在根本差异。每个物种实际上构成一个独立领域,需要专门验证。
数据有限
人医医学 AI 受益于数十年通过有意义使用授权和标准化编码系统推动的数字化[30]。兽医医学缺乏同等基础设施,导致非结构化自由文本的"低资源"数据环境[31]。脓皮症的诊断可能只是一个句子片段——"皮肤发红,疑似脓皮症,处方头孢"——而非编码条目。当 AI 用于 440 万份伴侣动物记录时,仅能完整提取 39% 犬和 37% 猫记录中的药物剂量、疗程和诊断[27]。这反映的是病历记录现实而非算法失败,对基于此类数据训练的任何 AI 都有直接影响。
然而,兽医领域确实从一些数据优势中受益。大型临床数据库如 VetCompass(英国和澳大利亚)[32]、SAVSNET[33] 和犬老龄化项目[34] 让研究人员可以访问数百万去标识化临床记录用于基于群体的研究。与人医受美国严格法规(如健康保险流通与责任法案)管辖不同,兽医记录在研究获取方面面临相对较少的法律监管,可能改善 AI 开发的数据可用性[35]。这些资源使流行病学研究达到在人医中因隐私和监管限制而难以实现的规模。此外,对兽医研究"大数据"日益增长的兴趣正在带来越来越多的标注数据集。
多样化实践环境
兽医医学涵盖根本不同的环境。例如,使用复选框记录检查的高流量疫苗诊所、文档简略的普通全科、有复杂病例和详细记录的专科转诊、或有时间压力且病史可能不完整的急诊。此外,可能是 exotic 物种或不常用药物。在转诊医院验证的 AI 工具在普通全科中可能表现不佳[19]。这不是因为系统有缺陷,而是因为人群、文档风格和临床背景差异很大。
监管空白
美国食品药品监督管理局(FDA)监管人医 AI 医疗器械,要求在上市前证明安全性和有效性[36]。兽医 AI 没有等同机构。产品可以在没有开发者以外任何监督的情况下进入市场[17]。这意味着没有强制验证标准、没有训练数据透明度要求,评估责任转移到个体兽医身上。
域迁移问题
这些因素汇聚成域偏移:在一个上下文中训练的模型无法泛化到另一个[37,38]。标准评估使用来自训练数据的保留集,仅证明内部有效性——模型在该特定数据集中学习了模式。外部有效性通过在真正独立的数据上的性能来衡量,需要单独评估。例如,在大学医院数据上训练的模型可能学到"淋巴结肿大预测淋巴瘤",因为在转诊人群中确实如此。部署在初级保健时,淋巴结肿大通常反映牙齿感染或反应性炎症,模型将系统性地过度预测肿瘤。学到的相关性是领域特定的,而非医学普遍的[39]。除了群体水平偏移外,模型还可能学习训练数据中的非临床伪影。例如,AI 模型可能部分基于文档风格或特定服务措辞而非临床内容来做诊断预测,学会将语言模式与写作风格而非潜在病理关联。
理解人工智能性能指标
评估 AI 工具需要驾驭两个使用不同术语、强调性能不同方面的指标传统。AI/ML 社区通常报告精确率、召回率和 F1 分数。或者,临床文献倾向于使用敏感度、特异度和预测值。这些框架重叠但不等同,评估可能报告任一框架的工具时,理解两者都是必要的。严格评估需要理解用于表征 AI 性能的指标。
混淆矩阵:所有分类指标的基础
所有分类指标都源于混淆矩阵——与评估任何诊断测试相同的框架,将预测分为四种结果(表1)[40]。
真阳性是 AI 正确识别存在的疾病。假阳性(I 类错误)是 AI 错误标记不存在的疾病。假阴性(II 类错误)是 AI 未识别存在的疾病。真阴性是 AI 正确识别不存在的疾病。
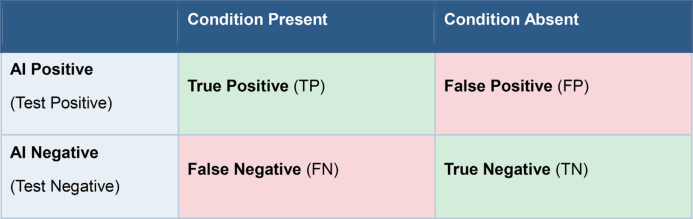
兽医在解读实验室结果或影像发现时常规运用这种推理。AI 评估需要同样的逻辑,以同等严谨应用。这些错误的临床后果因上下文而显著不同[40]。例如,考虑一个 AI 系统被依赖于骨肉瘤诊断。骨肉瘤假阴性延误危及生命的疾病诊断。同一疾病的假阳性可能导致不必要的治疗甚至安乐死。评估不仅要考虑错误率,还要考虑错误后果。
机器学习框架:精确率与召回率
ML 研究通常报告精确率和召回率,通常组合为 F1 分数[41]。
召回率(等同于敏感度)回答:在所有阳性病例中,系统识别了多少比例?
召回率 = TP / (TP + FN)
精确率(等同于阳性预测值)回答:在所有系统标记为阳性的病例中,有多少比例是正确的?
精确率 = TP / (TP + FP)
F1 分数是精确率和召回率的调和平均数(一种惩罚两个值之间极端不平衡的平均数):
F1 = 2 × (P × R) / (P + R)
该框架强调正类性能,适用于负类很大、异质或定义不明确的 ML 任务[41]。真阴性不出现在精确率或召回率计算中。例如,在评估从临床笔记中识别药物提及的信息提取系统时,"非药物提及"的范围定义不明确,使特异度计算有问题。精确率和召回率通过仅关注阳性预测和阳性病例来避免这个问题。
临床框架:敏感度与特异度
临床医学通常报告敏感度和特异度,对称处理两个类别[42]。
敏感度(也称召回率或真阳性率):在所有患病人群中,系统正确识别为阳性的比例是多少?
敏感度 = TP / (TP + FN)
高敏感度意味着漏诊少,对于不能漏检疾病的筛查应用至关重要。一个敏感度 95% 的肺炎检测 AI 会漏诊 5% 的肺炎病例。
特异度:在所有未患病人群中,系统正确识别为阴性的比例是多少?
特异度 = TN / (TN + FP)
高特异度意味着误报少,当假阳性导致不必要干预、客户焦虑或不可逆决定时至关重要。考虑犬布氏杆菌病:假阳性可能导致安乐死和对人畜共患传播给家人的重大担忧。
注意特异度和精确率不等同,它们回答根本不同的问题[42]。特异度关注真阴性的性能(在所有健康患者中,多少被正确识别为健康?),而精确率关注阳性预测的可靠性(在所有被标记为患病的患者中,多少确实患病?)。一个系统可以表现出高特异度但低精确率,反之亦然,取决于疾病患病率。
临床医生还使用阳性预测值(PPV)和阴性预测值(NPV):
PPV = TP / (TP + FP) = 精确率 NPV = TN / (TN + FN)
PPV 在数学上与精确率相同;临床和 ML 社区对同一数量使用不同术语[43]。
敏感度-特异度权衡
在任何给定决策阈值下,敏感度和特异度呈反向关系[44]。调整 AI 以捕获更多真阳性(高敏感度)通常会增加假阳性(降低特异度)。开发者根据不同错误的相对成本选择阈值,但这些选择可能与特定临床背景不一致,因此独立考虑这一点至关重要。
为敏感度优化的筛查工具会标记边界病例,产生需要随访的假阳性。为特异度优化的确证工具会漏诊边界病例但在阳性时提供高置信度。两种优化本质上都不正确;适当阈值取决于临床应用[44]。
患病率问题
精确率(即 PPV)在很大程度上取决于疾病患病率,而敏感度和特异度则不然[42]。这就是为什么临床研究人员倾向于使用敏感度和特异度——它们在不同疾病率的人群中保持稳定,支持跨环境比较。
考虑一个敏感度 95%、特异度 95% 的 AI 应用于两个人群(表2):
表2 患病率对精确率影响的演示:两个人群具有相同的特异度和敏感度
| 人群 A(50% 患病率) | 人群 B(5% 患病率) | |
| 真阳性 | 475 | 47 |
| 假阴性 | 25 | 3 |
| 真阴性 | 475 | 902 |
| 假阳性 | 25 | 48 |
| 精确率(PPV) | 475/(475+25) = 95% | 47/(47+48) = 49% |
同一系统,相同的敏感度和特异度,在一个人群中产生 95% 的精确率,在另一个人群中仅 49%[42]。如果工具从人工平衡类别的验证集中报告精确率,低患病率环境中的真实世界性能将大幅恶化。数据集平衡——研究人员有意纳入大致相等数量的阳性和阴性病例——是 ML 开发中的标准做法,因为它改善模型训练。然而,它创造了不反映临床现实的验证条件。
这对兽医应用很重要,因为许多疾病罕见。以骨肉瘤为例,AI 工具在使用富集阳性病例的大学医院数据的验证研究中可能表现出极好的精确率;在真实患病率低的普通全科中可能主要产生假阳性。当报告精确率或 F1 而没有患病率信息时,需要谨慎。
框架间转换
在兽医 AI 工具评估中,临床和计算机科学术语都在使用[43]。ML 起源的工具(如查看文本的自然语言处理系统、通用计算机视觉)通常报告精确率、召回率和 F1。临床验证的工具(如诊断影像、筛查应用)通常报告敏感度、特异度和 PPV/NPV。一篇 ML 论文仅报告精确率和召回率,无法提供关于特异度的直接信息。一篇临床论文报告敏感度和特异度,仅在已知患病率时才能计算精确率。理想情况下,应提供混淆矩阵所需的基础数据。这允许在跨不同验证研究评估工具时进行更好的比较,并确保在具有可比患病率的人群上比较等效指标。
ROC 曲线下面积:阈值独立性能
每个 AI 分类系统都有一个内部阈值,决定在将病例标记为阳性之前必须有多可疑。这个阈值不是固定的,而是代表一个有直接临床后果的设计选择。降低阈值,系统标记更多真实疾病(更高敏感度)但产生更多误报(更低特异度)。提高阈值,假阳性减少但假阴性增加。每个阈值都体现权衡;没有同时优化两者的设置。
受试者工作特征(ROC)曲线明确展示了这个权衡空间[45]。形式上,ROC 曲线在所有可能阈值下绘制敏感度(真阳性率)vs 1—特异度(假阳性率)(图1)。曲线上每个点代表不同的操作阈值:左上角(0, 1)代表理想性能——完美敏感度和完美特异度,而对角线代表随机机会(AUC = 0.5)。任何有用的分类器都应在该对角线上方,曲线越向左上角弯曲表示判别能力越好。
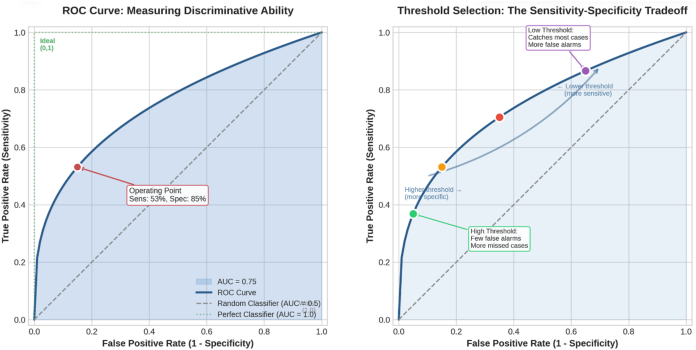
图1.(左)AUC = 0.75 的 ROC 曲线,AUC 以蓝色阴影显示。操作点指示所选阈值(敏感度 53%,特异度 85%)。虚线对角线代表随机机会。(右)阈值选择如何产生敏感度-特异度权衡:降低阈值增加敏感度但降低特异度。
ROC 曲线下面积(AUC-ROC)将该曲线总结为单个值,量化独立于阈值选择的判别能力。AUC 回答的问题是:"给定一个患病病例和一个未患病病例,系统正确将更高怀疑度分配给患病病例的频率是多少?"AUC 为 0.90 意味着正确排序发生在 90% 的时间[45]。图2 说明不同 AUC 值的分类器如何表现出不同的判别能力。
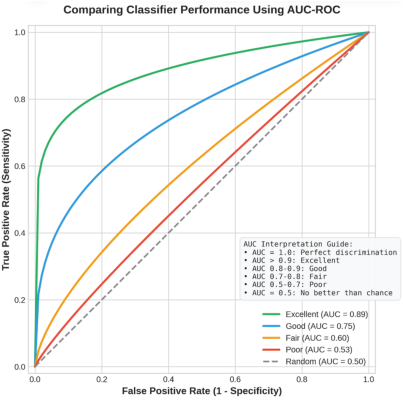
图2. 不同判别能力分类器的比较。较高 AUC 值对应更向左上角弯曲的曲线,表示阳性和阴性病例之间更好的分离。解读指南显示 AUC 评估的标准基准。
通用 AUC 解读指南如下:
- AUC = 1.0:完美判别
- AUC > 0.9:通常认为优秀
- AUC 0.8–0.9:良好
- AUC 0.7–0.8:一般
- AUC = 0.5:不优于随机
AUC 可用于比较系统,但有必须理解的重大局限。
首先,AUC 衡量的是判别力——系统能否区分患病和健康病例——而非任何特定操作点的分类准确率。AUC 为 0.95 并不意味着 95% 准确率;它意味着当呈现一个患病和一个健康病例时,系统在 95% 的时间将更高怀疑度分配给患病病例。临床部署需要选择特定阈值,此时敏感度-特异度权衡重新显现。AUC 优秀的系统在部署选择的阈值下仍可能表现不佳。
其次,当疾病患病率低时(ML 研究人员称为类别不平衡的情况,在兽医应用中常见——大多数患者没有被筛查的疾病),AUC 可能产生误导[46]。ROC 曲线对称处理敏感度,可能掩盖不平衡数据集中差的阳性预测性能。在这种情况下,精确率-召回率(PR)曲线和相应的 PR 曲线下面积可能提供更丰富的总结[41]。当正类罕见时,高 AUC-ROC 的系统在任何实际操作阈值下可能产生不可接受的低精确率。
实际含义很明确:当报告 AUC 时,需要部署时特定阈值下的性能指标才能进行评估。仅有 AUC 而没有操作阈值下的敏感度、特异度和精确率,提供的临床评估信息不足。
校准:当置信度与现实匹配时
许多 AI 系统不仅输出预测,还输出置信度分数,如"85% 概率肺炎"而非简单的"检测到肺炎"。这些概率估计只有在其含义与声称相符时才有用。校准良好的系统产生与实际频率匹配的置信度分数:如果系统对 100 个预测分配 80% 置信度,大约 80 个应被证明正确。
校准很重要,因为置信度分数经常指导临床决策。以 95% 置信度标记的发现可能引发与 60% 标记的发现不同的行动。如果这些数字不可靠,它们误导而非提供信息。
校准不良在深度学习模型中很常见,这些模型经常表现出系统性过度自信[47]。一个报告"95% 确信这是骨肉瘤"的 AI,正确的时间可能远少于 95%,因为该数字反映的是模型内部数学而非真实诊断概率。这不仅是一个小的技术问题;它直接影响临床医生如何解读和基于 AI 输出采取行动。
校准可通过可靠性图评估,该图绘制预测概率与观察频率的关系(图3),并通过 Brier 分数或期望校准误差等指标量化(两者越低表示校准越好)[47]。当基础概率分数不可访问时(如许多大语言模型 LLM),替代方法包括提示模型口头表达置信度或生成多个回复并将不一致性视为不确定性信号[48]。这些方法的验证仍不如传统校准评估。
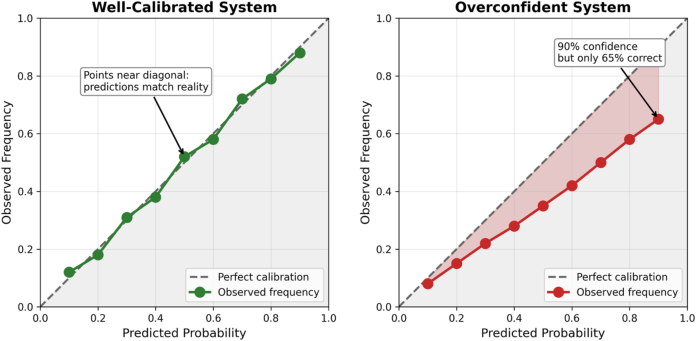
图3. 可靠性图比较校准良好的系统(左)与过度自信的系统(右)。沿对角线的点表示良好校准;偏离对角线下方表示过度自信。
当工具提供置信度分数时,如果没有校准评估,应将其视为相对排名(越高表示越可疑)而非真实概率。
为什么准确率具有误导性
准确率是所有预测中正确的比例,是最常报告的指标,也经常最具误导性[49]。
准确率 = (TP + TN) / (TP + TN + FP + FN)
考虑这个例子。一个 AI 工具被开发用于检测目标人群中患病率 5% 的疾病。一个对每个病例都预测"阴性"、完全忽略所有输入数据的系统,达到 95% 准确率。它什么也没学到,什么也没检测到,提供零临床价值。但按准确率指标,它看起来非常成功[49]。这不是虚构场景。许多临床重要疾病罕见,验证数据集通常以人工平衡构建(50% 阳性和 50% 阴性),使准确率相对于真实世界性能虚高。一个在平衡验证集上报告 90% 准确率的系统,在真实患病率为 2% 的人群中部署时可能表现非常不同。
实际含义很简单:评估 AI 工具时,在考虑使用之前,应要求提供每个类别单独报告的敏感度和特异度(或精确率和召回率)。这些指标揭示系统在阳性和阴性病例上的独立表现。准确率可报告以求完整,但绝不应作为主要指标,跨不同患病率数据集比较准确率没有意义。仅凭总体准确率而不分解各类别具体表现、没有患病率信息,临床评估不充分。当其作为主要报告指标出现而没有各类别性能时,应引起对验证严谨性的怀疑。
标注者间一致性:性能上限
AI 评估中一个关键但经常被忽视的方面是衡量性能所依据的"金标准"标签的质量。
标注问题
监督式 AI 从标注示例中学习。例如,标注为"肺炎存在"或"正常"的 X 光片,或按肿瘤分级分类的组织病理切片。这些标签由人类专家生成。如果专家对正确标签存在分歧,AI 性能从根本上受该分歧限制。当这些标签构成唯一可用的金标准时,系统不能被评估为优于其训练标签。
标注者间一致性(IAA)量化人类标注者之间的一致性[50,51]。最常见的测量是 Cohen Kappa,计算两个标注者之间一致性并校正机会因素:
κ = (po − pe) / (1 − pe)
其中 po 是观察一致性,pe 是机会预期一致性。Fleiss Kappa 将此计算扩展到两个以上标注者。
解读指南如下[50]:
- κ > 0.80:优秀一致性
- κ 0.60–0.80:高度一致性
- κ 0.40–0.60:中等一致性
- κ < 0.40:差一致性
这些阈值是惯例而非绝对标准,但为评估标签质量提供有用基准。然而,IAA 指标有显著局限:不同统计量对同一数据可能产生大不相同的分数,本质复杂的判断任务无论标签质量如何都会产生较低一致性,因此解读这些值时上下文至关重要[52]。
为什么标注者间一致性限制评估
考虑一个具体例子:两位认证放射科医生审查同一组胸部 X 光片寻找肺炎,85% 的时间达成一致(κ ≈ 0.70)。其余 15% 代表专家意见真正分歧的病例,可能因边界表现、模糊发现或合理专家得出不同结论的病例。
一个在一位放射科医生标签上训练和评估的 AI 系统,不能有意义地说"超过"85% 性能。如果系统与放射科医生 A 达到 95% 一致性,它可能仅与放射科医生 B 达到 80% 一致性。不知道哪位放射科医生在争议病例中"正确"(通常是无法回答的问题),我们无法确定系统学到的是真正的诊断准确性还是仅仅一位专家的标注倾向。
这对解读验证研究有直接影响。AI 性能应对照 IAA 背景化,而非假设完美金标准[51]。一个在 IAA 85% 的标签上达到 88% 准确率的系统,表现大约在专家分歧水平。一个在 IAA 70% 的标签上达到 95% 准确率的系统需要审查,它可能表明方法学问题如测试集污染(训练时无意中包含了评估集数据)或标签泄漏(模型学会从数据中的伪影而非临床特征预测标签),而非真正优越的性能。
低标注者间一致性标志任务模糊
当专家无法达成一致时,问题可能不在 AI 而在临床概念本身。一些诊断类别本质上是模糊的;其边界取决于合理临床医生做出不同选择的阈值。在这种情况下,适当的回应可能是任务重新定义而非算法改进。
在极少数情况下,AI 可能真正检测到人类专家无法察觉的模式,正如从视网膜图像预测心血管风险因素的深度学习系统所证明的那样——临床医生无法在视觉上评估这些因素[53]。验证此类主张需要基于结局的验证,将预测与组织病理学、治疗反应或生存相关联,而非依赖专家标签作为金标准[54]。
标注者间一致性设定评估上限
如果在 AI 评估前未进行 IAA 计算,就无法确定报告的性能代表真正能力还是标签生成方式的伪影。
对兽医人工智能的启示
兽医 AI 在建立可靠金标准方面面临挑战:
专科人员有限
认证兽医放射科医生、病理学家和心脏病专家相对于病例数量稀缺。大规模标注工作可能依赖全科医生,其诊断准确性与专科共识不同。犬心脏病专家可能不是猫心脏病专家。没有适当物种特定专业知识生成的标签可能反映知识差距而非金标准。
回顾性标注局限
从临床记录中得出的训练标签使用结局(如组织病理学结果、治疗反应、临床进展)作为诊断真相的代理。这些代理引入系统性偏倚——进行活检的病例可能与保守处理的病例持续不同,治疗反应将诊断准确性与治疗选择混为一谈。
评估 AI 工具时,必须提出相关问题:训练标签如何生成?由谁生成?IAA 是否测量和报告?用非专科标签验证或没有 IAA 评估的工具,为临床采用提供的证据不足。IAA 报告的缺失应引起对验证严谨性的担忧。
验证层级与外部有效性
验证类型
验证存在强度层级:
- 内部验证:在与训练数据同源的保留数据上测试性能。这证明模型在该数据集中学习了模式,但对泛化能力无可奉告。
- 外部验证:在真正独立的数据上测试,来自不同机构、时间段或人群。这提供可迁移性证据。
- 前瞻性验证:在模型开发后收集的新病例上、真实临床条件下测试。这是最强证据但很少执行。
- 多中心验证:跨不同设备、人群和实践的 diverse 机构,提供对泛化性最大的信心。
泛化差距
已发表证据显示一致的"泛化差距"——AI 性能在外部数据上下降[55]。一项对放射诊断深度学习算法的系统综述发现,绝大多数(81%)外部验证模型性能较内部验证下降,近一半(49%)显示 AUC 至少下降 0.05,近四分之一(24%)下降 0.10 或更多[55]。
若干因素驱动这些性能差距。疾病患病率、病例人口学和严重程度分布在不同机构间不同。在疾病常见的地方训练的模型可能在别处遇到根本不同的患者人群。图像特征也因设备、定位方案和图像质量标准的差异而在各站点间显著变化。标注实践引入额外变异,因为一个机构称为特定发现的内容可能不完全匹配另一个机构的诊断标准。也许最成问题的是虚假相关性——模型学会依赖在训练数据中恰好预测结局但无真正诊断价值的特征。这些可能包括机构文档模板、设备特定伪影或训练环境独有的成像方案。
对于 LLM,记忆与泛化之间的关系因任务类型而异:知识检索任务在很大程度上取决于信息是否出现在训练数据中,而推理任务表现出更大的泛化性,性能与训练数据频率关系较小[56,57]。
最低验证要求
对于临床部署,某些验证标准应视为不可协商。在诊所使用的任何 AI 产品的验证应包括:
- 在独立数据上的外部验证
- 验证人群特征的披露(如疾病患病率、转诊 vs 初级保健环境)
- 相关亚组的性能(如物种、品种、疾病严重程度)
- 反映估计精度的置信区间(需要足够样本量)
没有独立验证的开发者报告指标值得怀疑。同行评审发表比营销材料提供更多信心,但即使是已发表研究也可能有方法学局限。
模态特定考量
AI 记录工具与病历记录
AI 记录工具使用语音识别和 LLM 从问诊音频生成主观、客观、评估、计划(SOAP,标准临床文档格式)笔记。与诊断 AI 不同,"金标准"部分是主观的,因为笔记质量涉及临床完整性、适当术语和对问诊的准确呈现。
AI 记录工具的特定评估考量包括:
- 幻觉风险:生成式 AI 可能产生合理但虚构的内容,必须系统对照音频记录验证[58]。评估 LLM 生成临床文档的研究观察到幻觉率 1.47% 和遗漏率 3.45%,错误可能带来重大临床安全和法律影响[58]。
- 术语准确性:工具是否处理兽医特定术语、缩写和物种特定语言?
- 完整性指标:问诊中临床相关信息的多大比例被捕获?
兽医 AI 记录工具的证据基础仍然有限,同行评审验证研究很少。
诊断影像 AI
数字影像 AI 代表最成熟的兽医应用,涵盖放射学、超声心动图和其他模态。然而,同行评审文献仍然相对稀少,在兽医临床和生物医学研究中使用 ML 进行影像相关任务的发表很少[6]。
评估考量包括:
- 发现覆盖范围:工具检测有限列表的异常。列表之外的疾病不会被识别。
- 物种/品种验证:解剖结构差异很大(放射学中的胸廓形状、超声心动图中的心脏解剖),需要跨相关人群验证,包括品种特定疾病如心肌病。
- 敏感度 vs 特异度权衡:了解工具如何优化,是筛查(高敏感度)还是确证(高特异度)。
- 与放射科医生标准的比较:性能应对照认证解读设基准,并报告阅片者间一致性[59]。
病理与细胞学 AI
病理 AI 应用包括肿瘤分级、淋巴瘤分类和自动细胞计数。独特考量:
- 制片变异:染色方案和切片制备影响图像特征。
- 扫描仪校准:不同全切片成像平台产生不同输出。
- 病理学家间一致性:金标准本身显示变异性;AI 性能应对照专家一致性背景化。
总结
AI 工具为改善兽医医学提供巨大潜力。实现这一潜力需要评估素养,理解敏感度、特异度、精确率、召回率、F1 分数、AUC 和 AUC-ROC 等指标、IAA 的作用,以及外部验证的关键重要性。
核心问题很简单:敏感度和特异度是多少?在什么人群上?与什么专家基线比较?有什么外部验证?这些不是采用的障碍,而是负责任采用的前提。
在缺乏监管的情况下,行业必须制定和应用严格标准。本文提出的框架以定量评估指标和实用清单为基础,使兽医专业人员能够做出知情决策。随着 AI 普及,这些评估技能将像任何其他临床能力一样必不可少。
临床要点
- 评估人工智能(AI)工具需要理解核心性能指标(敏感度、特异度、精确率、召回率、F1 分数、AUC 和 AUC-ROC),并认识到报告的性能在很大程度上取决于所测试的人群。
- AI 性能从根本上受创建训练数据的专家标注者间一致性的限制,这一概念在验证研究中经常被忽视。
- 在独立数据集上进行外部验证至关重要,因为 AI 工具在原始训练环境之外部署时经常性能下降;在缺乏监管的情况下,临床医生有责任在采用前进行严格评估。
利益冲突声明
B. Hur 受雇于 Veterinary Information Network。该雇佣关系未影响本文内容。其余作者无利益冲突需声明。
参考文献
- Sobkowich KE. Demystifying artificial intelligence for veterinary professionals. Am J Vet Res 2025;86(S1):S6–15.
- Albergante L, O'Flynn C, Meyer GD. Artificial intelligence in small animal veterinary applications. J Am Vet Med Assoc 2025;263(3):388–94.
- Gabor S, Danylenko G, Voegeli B. Familiarity with AI drives optimism and adoption among veterinary professionals. Am J Vet Res 2025;86(S1):S63–9.
- Bollig L, et al. Language models in veterinary clinical practice. Vet Clin Small Anim 2026;56:1087–1104.
- Basran PS, et al. AI-assisted interpretation of veterinary radiographs. Vet Clin Small Anim 2026;56:1105–15.
- Reviews of imaging AI in veterinary medicine. 2024.
- Mäntylä Noble PJ, Farrell SO. Disease and health surveillance in companion animals using AI and ML. Vet Clin Small Anim 2026;56:1151–64.
- AI-assisted AI development. 2024.
- Topol EJ. High-performance medicine. Nat Med 2019;25:44–56.
- Comparison of AI evaluation frameworks. 2023.
- No-code AI tools proliferation. 2024.
- Citizen developers in healthcare AI. 2024.
- Overhyped AI in medicine. 2023.
- Risks of unvalidated clinical AI. 2024.
- Veterinary AI landscape review. 2025.
- Species-specific AI challenges. 2024.
- Regulation gaps in veterinary AI. 2024.
- FDA approach to medical AI. 2023.
- Domain shift in clinical AI. 2023.
- Beede E, et al. Enterprise AI in veterinary medicine. 2023.
- Rajkomar A, et al. Sepsis prediction algorithm external validation. 2018.
- AI scribes reduce clinician burden. 2024.
- Burnout reduction in veterinary practice. 2024.
- Communication efficiency tools. 2024.
- Population-based veterinary studies. 2024.
- Longitudinal records AI analysis. 2024.
- Hur B, et al. Extraction from 4.4M companion animal records. 2024.
- Anatomic variation across breeds. 2023.
- Cross-species AI transfer limitations. 2024.
- Meaningful use and EHR digitization. 2020.
- Low-resource NLP in veterinary. 2023.
- VetCompass. 2024.
- SAVSNET. 2024.
- Dog Aging Project. 2024.
- Privacy regulations in veterinary research. 2023.
- FDA AI/ML action plan. 2023.
- Domain adaptation in ML. 2022.
- Generalization gap literature. 2023.
- Spurious correlations in clinical AI. 2023.
- Altman DG, Bland JM. Diagnostic tests 1: sensitivity and specificity. BMJ 1994;308:1552.
- Saito T, Rehmsmeier M. The precision-recall plot. PLoS One 2015;10:e0118432.
- Altman DG, Bland JM. Diagnostic tests 2: predictive values. BMJ 1994;309:102.
- Same metrics different names. 2023.
- Varying thresholds and tradeoffs. 2022.
- Hanley JA, McNeil BJ. The meaning and use of the area under a ROC curve. Radiology 1982;143:29–36.
- Davis J, Goadrich M. The relationship between precision-recall and ROC curves. ICML 2006.
- Guo C, et al. On calibration of modern neural networks. ICML 2017.
- Confidence elicitation in LLMs. 2024.
- Accuracy is misleading in imbalanced datasets. 2023.
- McHugh ML. Interrater reliability: the kappa statistic. Biochem Med 2012;22:276–82.
- Labels are not ground truth. 2023.
- Limitations of IAA statistics. 2022.
- Poplin R, et al. Prediction of cardiovascular risk factors from retinal fundus photographs. Nat Biomed Eng 2018;2:1–9.
- Outcome-based validation. 2023.
- Nagendran M, et al. Comparing deep learning algorithms vs clinicians. BMJ 2020;369:m1683.
- Memorization vs generalization in LLMs. 2024.
- Chan S, et al. Reasoning vs retrieval in LLMs. 2024.
- O'Connor K, et al. Hallucination in LLM clinical documentation. 2024.
- Radiologist agreement as benchmark. 2023.
- Additional references as listed in source.