利用人工智能和机器学习进行伴侣动物疾病与健康监测

利用人工智能和机器学习进行伴侣动物疾病与健康监测

Peter-John Mäntylä Noble, BSc, BVM&S, PhD, Sean Oliver Farrell, BSc, PhD
关键词
- 电子健康记录
- 疾病监测
- 语言模型
要点
- 大型临床记录库和新型文本处理方法为兽医健康与疾病监测带来了令人振奋的机遇。
- 从词搜索到基于 Transformer 的语言模型(如 PetBERT 和 VetBERT)等方法,可实现高效自动化的疾病和综合征编码。
- 使用兽医文本对语言模型进行领域特定预训练,性能显著优于通用模型。
- 模型泛化能力、标准化评估框架和兽医记录隐私保护去标识化方法方面仍存在关键差距。
- 生成式模型提供了有趣的机遇,但也存在潜在的环境成本。
背景
历史上,伴侣动物的疾病和健康监测理所当然地排在公共卫生监测和紧密关联的食品动物疾病监测之后。后两个领域的法定监测资金充足,深度嵌入医疗和食品动物生产行业及其监管机构。在伴侣动物领域,疾病和健康监测在很大程度上由学术界以及保险、制药和宠物食品制造商等特定行业承担。
宠物数量正在迅速增长,英国 60% 的家庭(1720 万户)拥有宠物[1],为经济做出重大贡献(估计英国每年超过 200 亿英镑)[2]。在美国,71% 的家庭(9400 万户)拥有宠物[3],2024 年为经济贡献 3120 亿美元[4]。此外,近期大流行表明严重急性呼吸综合征冠状病毒 2 型(SARS-CoV-2)存在人传动物感染犬猫的现象[5,6]。而且,随着人畜共患病和抗微生物药物耐药性成为全球卫生安全的双重威胁,理解人-动物界面的疾病模式和耐药机制变得至关重要[7–11]。兽医电子健康记录(veterinary electronic health records, vEHR)还被用于支持药物流行病学,通过监测不良事件报告来提高药物安全性并为不同动物群体的循证处方提供信息[12,13]。最后,可能对环境产生影响的药物(如驱虫药)的常规使用需要了解疾病患病率以合理管理这些药物的使用,凸显了可由伴侣动物疾病监测提供信息的关键 One Health 视角[14]。
鉴于伴侣动物监测中的资源限制,显然需要优化方法以尽量减少此项任务的时间和成本。两项相对较新的发展具有革新和加速伴侣动物健康与疾病监测的潜力。第一,几乎所有兽医诊所和实验室转向 vEHR,使得大规模汇总记录成为可能,创建了大型可分析数据集[15–18]。第二,计算成本的大幅降低允许使用各种人工智能(artificial intelligence, AI)工具进行数据分析。然而,vEHR 中自由文本临床叙述的主导地位带来了独特挑战,包括非标准化术语、不一致的缩写使用、拼写错误、否定和依赖上下文的语言。这些特征需要复杂的自然语言处理(natural language processing, NLP)方法,从非结构化临床文档中提取有意义的监测信号[19,20]。
使用大规模 vEHR 集合和 AI 来增强疾病和健康监测,为执业兽医提供了独特的机遇——既可以通过参与大规模数据汇总计划来推动研究,又可以从这些系统通过同时分析数百万条记录生成的群体水平流行病学洞察和早期爆发预警中受益。以下各节将重点讨论与分析 vEHR 相关的挑战,以及 AI 方法如何加速这项任务。
兽医临床文本的独特挑战
如前所述,临床自由文本可能存在标点缺失、上下文特定和过载的缩写、否定和词截断等问题。图1展示了一个自由文本 vEHR 的示例,突出了细节的丰富性和提取结构化信息的潜在挑战。该叙述包含领域特定缩写(URT、U/F、PE、UR、Hr、SMLN、nAD 和 INI),包括在其他记录中具有不同含义的缩写(R/V 此处指复诊,在其他记录中指转诊兽医),标点和语法差,拼写错误(halistosis、tp、concer),以及否定发现(not off his food、no history re U/F)。直到最近,兽医医学中 NLP 工具的有限可用性极大地限制了大规模记录分析。再加上数据孤岛和缺乏数据标准,伴侣动物疾病监测的格局充满挑战[21]。
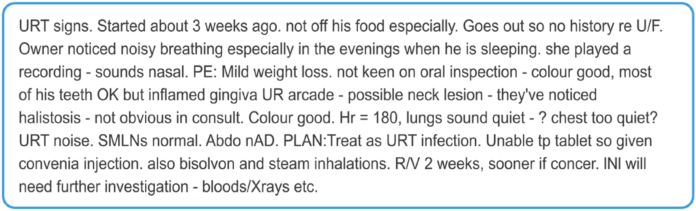
图1. 自由文本 vEHR 示例,展示了高水平的临床细节和提取结构化信息的固有困难。
临床文本分析方法
从兽医临床叙述中提取结构化信息经历了三种不同的方法论范式演进,每种在可解释性、可扩展性和性能之间提供不同的权衡(表1)。
基于规则的方法使用手工设计的模式(如正则表达式或关键字词典)来识别临床实体[22]。使用传统神经架构的学习方法(卷积神经网络[CNN]、循环神经网络[RNN]、长短期记忆网络[LSTM])则从训练数据中学习文本含义,使用静态词嵌入(通过 Word2Vec 等方法创建的编码词义的高维向量)来捕获文档语义[23]。Transformer 是复杂的神经网络模型,通过自注意力机制从根本上改变了临床 NLP。它们同时计算文档中所有词之间的关系,而非顺序处理[24]。Transformer 生成上下文化的嵌入,其中词表示根据周围文本动态调整。这种上下文敏感性在临床文本中至关重要:discharge 在 the wound had a nasty discharge 中指化脓,而 discharge the patient 指出院——这些区别是静态嵌入无法捕获的。
Transformer 现在通常部署为编码器-only 模型(如 BERT[25],通常 1 亿到 3.5 亿参数),针对文本理解进行优化;或解码器-only 生成模型(如 GPT[26] 和 LLaMA[27]),通常数十亿参数规模,根据提示词生成文本。预训练-微调范式首先在 ULMFiT 中展示[28],允许在数百万未标注文档上预训练的编码器模型捕获语言意义,随后使用小得多的标注数据集针对特定任务(如疾病编码)进行微调[25,29]。这种方法在专家标注数据仍然稀缺的兽医医学中特别有价值[21]。
表1 兽医临床文本分析方法比较
| 方法 | 优势 | 局限 | 实例 |
| 基于规则(正则/关键词) | 高度可解释;无需训练数据;窄任务部署快 | 对拼写变异和新术语脆弱;需要领域专业知识;人工评估将可用规模从数百万条记录减少到数千条 | 粘液瘤病[32];跳蚤/蜱监测[33] |
| 传统神经架构(CNN、RNN、LSTM) | 数据驱动的泛化超越精确模式匹配;通过词嵌入学习语义关系 | 顺序处理丢失长距离依赖;静态词向量混淆多个词义 | DeepTag[35];FasTag[69] |
| 编码器 Transformer(BERT 系列) | 上下文化嵌入;捕获长距离依赖;在小标注数据集上高效微调;比生成模型计算量低 | 需要预训练数据和计算;在分布外数据上性能下降 | VetTag[36];PetBERT[40];VetBERT[39] |
| 生成模型(GPT、LLaMA 等) | 少样本/零样本能力;灵活的自然语言交互;大上下文窗口可容纳临床词典 | 计算和环境成本高;在定义明确的任务上可能不如领域适配的编码器 | GPT-4 临床提取[44];SynSUM[45] |
以下各节探讨这些方法如何应用于健康监测和疾病监测中的特定挑战。
疾病编码与兽医电子健康记录
为记录进行疾病编码或标注是实现有效流行病学监测和大规模研究的基础[20]。早期工作探索了基于关键词的搜索作为从临床叙述中提取特定疾病的工具,如犬糖尿病研究[30]。然而,关键词方法的有效性因初级临床文本中频繁出现否定(如 not cancer)而受到削弱,研究表明否定术语出现在约 11% 的兽医自由文本句子中[31]。这一局限导致了复杂规则系统的开发,这些系统在粘液瘤病[32]、跳蚤和蜱活动[33,34]等疾病研究中找到了用途。然而,基于规则的框架固有地受限于设计者关于将出现何种词模式的假设,随着 EHR 中使用的语言演变,其性能可能下降。
使用神经网络架构进行自动化兽医疾病编码的开创性努力之一是 DeepTag——一个双向 LSTM,被训练预测 42 个顶层 SNOMED-CT 诊断编码[35]。DeepTag 局限于相对较少的宽泛诊断类别,意味着它不能直接应用于预测可能构成兽医疾病分类的数千个细粒度编码。
在 DeepTag 基础上,VetTag(一个基于编码器的 Transformer 模型)代表了重大进步,将诊断能力扩展到 4577 个细粒度 SNOMED-CT 编码[36]。该系统采用两阶段训练方法:在来自私营专科兽医集团的超过 100 万份未标注笔记上进行无监督预训练,随后在来自科罗拉多州立大学的 112,557 份专家标注笔记上进行监督微调。这种训练策略使 VetTag 能够利用丰富的未标注临床文本,同时仅需要适量的昂贵专家标注。
尽管取得了这些进展,DeepTag 和 VetTag 都是在同一贡献医院的数据上训练和测试的,留下了它们在分布外兽医数据(如初级保健 vEHR)上性能的不确定性。大语言模型(LLM)满足了对能够跨不同临床场景(从三级转诊中心到初级保健诊所)泛化的模型的关键需求。
基于 BERT 的语言模型与兽医电子健康记录
预训练和微调范式使 Transformer 在使用医学文本的任务中取得了优异性能。许多领域特定 BERT 模型已被创建。例如,BioBERT 在 PubMed 摘要和 PubMed Central 全文文章上训练[37],BioClinicalBERT 在包括临床笔记在内的各种临床语料库上训练[38]。第一个 vEHR 适配的 BERT 模型 VetBERT 源自 ClinicalBERT,并在 VetCompass Australia 语料库的约 1500 万份临床笔记上进一步预训练。这种适配使抗菌药物处方理由分类比 BERT-base 提高了 12%,凸显了使预训练数据与领域特定语言和临床特征对齐的重要性[39]。最近,PetBERT[40]——一个基于 BERT 的模型,在小动物兽医监测网络(SAVSNET)语料库的超过 5 亿个 token(词和词片段)上训练[41]——在从初级兽医临床记录检测疾病爆发的案例研究中取得了最先进的性能。
最近对 vEHR 临床语言模型的比较分析表明,领域特定模型(如 PetBERT 和 VetBERT)既可以在类似架构复杂度下超越人类临床模型,也可以在性能上与大得多的模型相媲美[42]。这些改进证明了为特定兽医场景(初级与转诊、物种特定应用等)领域适配语言模型的价值。
兽医临床文本中的生成式语言模型
虽然 BERT 等编码器-only Transformer 擅长理解和分类文本,但生成式语言模型为兽医信息学引入了根本不同的能力。这些基于解码器的架构——以生成式预训练 Transformer(GPT)和大语言模型 Meta AI(LLaMA)以及 Claude 和 Gemini 等商业系统为代表——被训练通过预测后续 token 来生成连贯文本。
生成式语言模型提示词现在可以包含非常大的文本跨度(上下文窗口),其中可以包含相关数据集,如疾病和临床体征词典,从而实现有用的记录标注和临床洞察生成[43]。
大型生成模型展示了令人印象深刻的少样本和零样本能力(在提示词中包含一个或几个所需输出示例),潜在地减少了对任务特定微调的需求。兽医医学中的初步应用包括使用 GPT-4 等通用模型从自由文本笔记中提取结构化临床信息[44],以及生成合成兽医临床数据用于模型开发[45]。
对于执行定义明确的重复性任务(如综合征分类或疾病编码)的运营性兽医监测系统,较小的领域适配编码器模型(如 PetBERT)通常在性能上与大型生成模型相当或更优,同时消耗的计算资源大幅减少[40,42]。
兽医电子健康记录用于综合征监测
综合征监测使用诊断前健康数据来检测潜在疾病爆发[46]。这种方法在兽医医学中特别有价值,因为不到 29% 的健康问题会跟进诊断检测[47],这意味着依赖实验室报告的监测仅抽样了高度选择性的临床病例子集。综合征(如呼吸道症状)在明确诊断之前就出现在临床笔记中,使其成为早期爆发检测的宝贵目标[48,49]。2007 年三聚氰胺污染宠物食品爆发证明了这一潜力:回顾性分析表明,一个新的综合征监测系统[50]本可以实现更早的食品召回,尽管临床体征没有像实验室数据变化那样快地触发警报[51]。
挑战在于准确识别综合征,因为像咳嗽或鼻分泌物这样的文本术语远比肺炎等特定标签更加多样化。基于 Transformer 的语言模型通过捕获上下文意义的能力提供了解决方案。PetBERT-ICD 基于 PetBERT 模型并在 ICD-11 层级上微调,成功识别了 2020 年英国犬肠道疾病爆发[52],比传统临床医生分配的编码提前约 3 周,证明了从自由文本进行可扩展、准确的综合征分类可以为动物健康监测解锁重要的早期预警能力。
通过主题建模无监督发现临床模式
虽然疾病编码和综合征监测等监督方法需要标注训练数据,但完全无监督方法可以在没有先验标注的情况下发现临床文本中的潜在模式。主题建模算法,包括潜在狄利克雷分配(latent dirichlet allocation, LDA)[53],自动识别共现词簇,这些词簇代表跨大型文档集合的连贯主题。在临床背景下,发现的主题可能对应疾病、综合征或治疗方案[54]。
主题建模的主要优势是不需要昂贵的人工标注,可以识别研究人员未预料到的模式。然而,主题质量取决于模型的仔细配置。此外,发现的主题可能不总是对应临床有意义的类别,而在 LDA 的情况下,词袋假设忽略了词序和上下文[53]。
在兽医背景下,一项将 LDA 应用于 SAVSNET 数据库 20 万份 vEHR 的研究表明,发现的主题与临床综合征对齐,并在一个主题(胃肠道症状)中暴露了与 2020 年全国胃肠道疾病爆发相对应的时间模式[55]。
最近的进展通过神经架构扩展了经典主题建模。例如,BERTopic 是一种基于 Transformer 的方法,利用上下文嵌入来发现考虑词上下文的主题[56]。这解决了经典 LDA 的一些局限,特别是在上下文词义方面,尽管它引入了额外的计算成本。
一项 SAVSNET 研究将 BERTopic 主题建模应用于来自 100 万只犬的 vEHR,展示了群体范围的健康相关表型探索[57],能够评估品种、年龄、性别和时间趋势。这表明主题建模可以扩展到大型兽医数据集,同时保持可解释性。
主题建模作为兽医临床信息学中监督方法的补充工具。它特别适合探索性分析(当临床表现的全部范围未知时)、大型 EHR 数据集的初步表征,以及为后续重点研究提供信息的假设生成。
兽医自然语言处理中的隐私、伦理与治理
非结构化自由文本数据分析受到平衡数据效用与患者隐私保护这一挑战的制约[58,59]。虽然结构化医疗数据可以相对直接地通过删除或掩码特定字段来去标识,但非结构化临床笔记因其叙述性质而呈现独特挑战[60]。这些自由文本记录可能包含嵌入在复杂临床叙述中的间接标识符,使传统匿名化方法不足以确保患者机密性,同时保留数据效用。
虽然传统的基于规则的匿名化方法已被广泛实施,但基于学习的方法已作为更复杂的解决方案出现,利用机器学习[61,62]和深度学习技术[63–67]创建可扩展的去标识化流程。这些自动化方法为资源密集型人工匿名化过程提供了有前景的替代方案,在受控环境中展示了令人印象深刻的性能。然而,其实际实施面临一个挑战:当遇到训练数据与真实世界应用之间的领域偏移时性能不稳定[63,65]。这一局限在医疗环境中尤其成问题,因为数据异质性因医疗机构、专科和地理区域的差异而固有存在。最值得注意的是,这些模型通常使用有限数据集开发和评估,未能捕获 EHR 中存在的全部变异范围。因此,当部署在分布外 EHR 数据上时,这些系统经常经历性能的大幅下降[63,64,67,68]。
目前没有关于 vEHR 应如何使用和共享的具体标准。虽然动物数据在美国、英国或欧盟的医疗信息法规下不被归类为敏感数据,但兽医临床笔记可能包含可识别信息,如主人或兽医姓名、地址和联系方式。此外,动物特定数据,如独特的宠物名结合地理空间细节,可能潜在地揭示主人身份。重要的是,作为私营企业,兽医诊所可能记录专有数据或客户行为洞察,如果处理不当,可能导致不公平竞争或声誉损害。因此,必须仔细关注记录去标识化,不仅为了隐私保护,也为了让主人和从业者继续参与数据共享计划而不担心负面后果。
临床自然语言处理中的评估框架
临床 NLP 模型的评估对于建立对医疗 AI 系统的信心和发现模型开发中的潜在偏见至关重要;临床数据的敏感性质为开放验证实践设置了重大障碍。
由于隐私问题导致的临床记录共享困难,促使研究人员探索替代方法,包括生成用于医学研究的合成数据集,这在理论上实现了安全数据共享而无重识别风险[69,70]。然而,在合成数据上训练的模型容易出现模型崩溃(即模型性能下降,因为它过拟合合成模式,导致输出的泛化性和多样性降低)[71],而仅在合成数据集上进行的验证缺乏真实世界数据验证的可信度[72]。
与合成方法相反,MIMIC 数据集代表了临床数据共享的黄金标准,展示了仔细的去标识化和适当的治理如何实现广泛的研究使用[73,74]。MIMIC-IV 包含来自贝斯以色列女执事医疗中心超过 65,000 名 ICU 患者和超过 200,000 名急诊科患者的数据,合并的 MIMIC-III 和 MIMIC-IV 数据集产生了超过 10,000 次引用,展示了可访问的临床数据集对医疗研究的变革性影响。
SAVSNET 团队推出了 PetEVAL[75],这是一个开放评估数据集,包含约 17,000 份 vEHR,标注了三个核心 NLP 任务:通过命名实体识别(NER)进行匿名化、通过 NER 进行疾病提取,以及作为多分类问题的综合征监测。为了支持开放发布同时保持机密性,每条记录都经过多位标注员的独立审查,以验证无残留标识符,解决了共享临床自由文本数据的关键障碍。匿名化任务实现了对旨在从初级兽医记录中编辑敏感信息的 NER 模型的系统基准测试,而疾病提取任务促进了将自由文本问诊可扩展地编码为结构化临床概念。综合征监测组件进一步将问诊分配到 ICD-11 层级的 20 个顶层章节,实现群体水平监测和下游流行病学分析。PetEVAL 可免费获取,并明确定位为社区基准,作者鼓励将其用作未来模型开发、比较评估的基线,并将数据集扩展到更多任务。然而,虽然 PetEVAL 代表了兽医 NLP 向标准化和透明评估迈出的重要一步,但仍明显需要独立团队发布更多 vEHR 数据集以支持外部验证、提高泛化能力并减少对单一来源基准的过度依赖。
环境考量:大语言模型与较小的 Transformer
生成式 LLM 和基于这些模型的工具具有环境影响。模型使用大量计算和能源来训练和进行推理。最近的估计表明,训练大型模型可能消耗相当于多辆汽车全生命周期排放的能源[76,77]。此外,数据中心冷却需要大量水资源,最近的分析表明,训练单个 LLM 可能消耗数百万升淡水用于冷却[78]。已经证明,使用较少计算的更紧凑模型可以与大得多的模型良好竞争[79]。语言模型处理的大规模并行特性要求使用图形处理单元(GPU)进行训练和高效推理,这些 GPU 能耗很高,虽然一些作者认为它们每条记录的瓦特数可能更低[80],但另一些作者认为更高效的 CPU 硬件也可能是值得追求的方向[81]。较小、更高效的模型通常可以达到与其大模型相当的性能[40,42]。较小模型也降低了研究参与门槛,因为它们需要更便宜的计算机硬件。
总结
伴侣动物的兽医监测一直是 One Health 疾病监测中的盲点,但近期 vEHR 向大型数据集汇总的进展与计算机方法的进步相结合,创造了新的机遇。
从基于规则系统到传统神经架构再到现代 Transformer 方法的演进,展示了该领域的快速成熟。PetBERT 和 VetBERT 等领域特定模型已证明,针对兽医临床文本的有针对性预训练可在保持计算效率和环境可持续性的同时产生显著的性能提升。
在创建国家级和国际代表性疾病监测数据集方面仍存在重大挑战。当前模型在其训练机构之外的泛化能力需要调查,因为许多系统是基于转诊医院数据而非大多数问诊发生的初级保健环境开发的。此外,捕获潜在可识别信息的风险要求开发和验证强大的去标识化框架。
环境可持续性考量必须整合到模型选择和系统设计决策中,确保 AI 驱动的监测进展与更广泛的 One Health 可持续发展目标保持一致。PetEVAL 等开放数据集提供了有价值的基准,但该领域将大大受益于额外独立开发的评估资源,以支持外部验证并减少对单一来源基准的过度依赖。
这些都是兽医界肯定能够克服的挑战。兽医信息学界的协作性质,加上对伴侣动物在 One Health 框架中重要性的日益认识,为解决这些障碍提供了坚实基础。随着计算方法的不断进步和国际合作的加强,AI 驱动的监测系统在改变我们监测和应对伴侣动物群体中新出现健康威胁的能力方面具有巨大前景。通过同时关注技术卓越和实际可持续性,兽医信息学界可以开发真正服务于动物、人类和环境互联健康的监测能力。
临床要点
- 你的记录是关键的原材料。 向数据科学计划贡献笔记直接使研究人员能够生成群体水平的健康洞察。
- 标注方法影响准确性。 简单的词模式匹配是脆弱的——否定术语、拼写变异和不一致的缩写都可能导致漏检或假阳性。语言模型更有效地捕获词上下文。
- 训练数据上下文影响适用性。 在转诊医院记录上开发的模型可能无法反映初级保健实践模式。
- 综合征监测检测趋势,而非诊断。 爆发检测可能基于临床体征而非确诊诊断,因此群体水平警报需要临床随访以探究原因。
- 通用 AI 工具未经验证用于兽医。 生成式 LLM 尚未在兽医临床文本上进行系统评估,因此在可用时应优先使用领域适配模型进行临床或监测应用。
写作过程中人工智能及人工智能辅助技术的声明
在准备本文的过程中,作者使用了生成式 AI。使用该工具后,作者根据需要审阅和编辑了内容,并对出版物的内容承担全部责任。
利益冲突声明
作者声明无利益冲突。
参考文献
-
UK pet food. UK pet population 2024. 2024.
-
Hepper. 19 incredible UK pet spending statistics & facts: updated in 2025. 2025.
-
Insurance Information Institute. Facts + statistics: pet ownership and insurance. 2024.
-
Pet advocacy network. 2024 economic impact of the US pet sector. 2024.
-
Bae J, Ro C, Kang Y, et al. Human-to-animal transmission of SARS-CoV-2, South Korea, 2021. Emerg Infect Dis 2023;29(5):1087–9.
-
Smith SL, Anderson ER, Cansado-Utrilla C, et al. SARS-CoV-2 neutralising antibodies in dogs and cats in the United Kingdom. Current Research in Virological Science 2021;2:100011.
-
Bidaisee S, Macpherson CNL. Zoonoses and one health: a review of the literature. J Parasitol Res 2014;2014.
-
McEwen SA, Collignon PJ. Antimicrobial resistance: a one health perspective. Microbiol Spectr 2018;6(2).
-
Kol A, Arzi B, Athanasiou KA, et al. Companion animals: translational scientist's new best friends. Sci Transl Med 2015;7(308).
-
Robertson ID, Irwin PJ, Lymbery AJ, et al. The role of companion animals in the emergence of parasitic zoonoses. Int J Parasitol 2000;30(12–13):1369–77.
-
Van Duijkeren E, Wolfhagen MJHM, Box ATA, et al. Human-to-Dog transmission of methicillin-resistant Staphylococcus aureus. Emerg Infect Dis 2004;10(12):2235.
-
Davies H, Blackwell E, Fins IS, et al. Recording of suspected adverse drug reaction reporting in veterinary free-text clinical narratives. J Small Anim Pract 2024;65(6):361–7.
-
Davies H, Noble PJ, Fins IS, et al. Developing electronic health records as a source of real-world data for veterinary pharmacoepidemiology. Front Vet Sci 2025;12:2025.
-
World Health Organization. One health. 2017.
-
Small animal veterinary surveillance network. SAVSNET. 2024.
-
Companion animal veterinary surveillance network. CAVSNET. 2024.
-
O'Neill DG, Church DB, McGreevy PD, et al. Prevalence of disorders recorded in dogs attending primary-care veterinary practices in England. PLoS One 2014;9(3):e90501.
-
Banfield pet hospital. State of pet health 2016 report. 2016.
-
Paynter AN, Dunbar MD, Creevy KE, et al. Veterinary big data: when data goes to the dogs. Animals 2021;11(7).
-
Davies H, Nenadic G, Alfattni G, et al. Text mining for disease surveillance in veterinary clinical data: part one. Front Vet Sci 2024;11:1352239.
-
Lustgarten J, Zehnder AM, Shipman W, et al. Veterinary informatics: forging the future between veterinary medicine, human medicine, and one health initiatives. JAMIA Open 2020;3:306–17.
-
Turchin A, Kolatkar NS, Grant RW, et al. Using regular expressions to abstract blood pressure and treatment intensification information from the text of physician notes. J Am Med Inform Assoc 2006;13(6):691–5.
-
Mikolov T, Sutskever I, Chen K, et al. Distributed representations of words and phrases and their compositionality. Adv Neural Inf Process Syst 2013;26.
-
Vaswani A, Shazeer N, Parmar N, et al. Attention is all you need. Neural Information Processing Systems 2017;31:6000–10.
-
Devlin J, Chang MW, Lee K, et al. BERT: pre-training of deep bidirectional transformers for language understanding. NAACL-HLT 2019:4171–86.
-
Radford A, Wu J, Child R, et al. Language models are unsupervised multitask learners. OpenAI Blog 2019;1(8):9.
-
Touvron H, Martin L, Stone K, et al. Llama 2: open foundation and fine-tuned chat models. 2023.
-
Howard J, Ruder S. Universal language model fine-tuning for text classification. ACL 2018;1:328–39.
-
Liu Y, Ott M, Goyal N, et al. RoBERTa: a robustly optimized BERT pretraining approach. arXiv 2019.
-
Heeley AM, O'Neill DG, Davison LJ, et al. Diabetes mellitus in dogs attending UK primary-care practices. Canine Medicine and Genetics 2020;7(1):1–19.
-
Cheng K, Baldwin T, Verspoor K. Automatic negation and speculation detection in veterinary clinical text. ALTA Workshop 2017.
-
Farrell S, Noble PJM, Pinchbeck GL, et al. Seasonality and risk factors for myxomatosis in pet rabbits in Great Britain. Prev Vet Med 2020;176:104924.
-
Farrell S, McGarry J, Noble PJM, et al. Seasonality and other risk factors for fleas infestations in domestic dogs and cats. Med Vet Entomol 2023;37(2):359–70.
-
Tulloch JSP, McGinley L, Sánchez-Vizcaíno F, et al. The passive surveillance of ticks using companion animal electronic health records. Epidemiol Infect 2017;145(10):2020–9.
-
Nie A, Zehnder A, Page RL, et al. DeepTag: inferring diagnoses from veterinary clinical notes. npj Digit Med 2018;1(1):1–8.
-
Wang T, Liu S, Paschke A, et al. VetTag: veterinary disease tagging. J Am Vet Med Assoc 2023.
-
Lee J, Yoon W, Kim S, et al. BioBERT: a pre-trained biomedical language representation model for biomedical text mining. Bioinformatics 2020;36(4):1234–40.
-
Alsentzer E, Murphy SG, Boag W, et al. Publicly available clinical BERT embeddings. Clinical NLP Workshop 2019:72–8.
-
Hassall C, Carter S, Faull RJ, et al. VetBERT: domain-specific BERT improves antimicrobial prescribing classification. Vet Rec 2024.
-
Davies H, Nenadic G, Alfattni G, et al. PetBERT: transformer-based syndromic surveillance. Front Vet Sci 2024.
-
Radford M, Goodall E, et al. SAVSNET. 2024.
-
Wang Z, et al. Comparative analysis of clinical language models on veterinary EHRs. 2025.
-
Singhal K, Azizi S, Tu T, et al. Large language models encode clinical knowledge. Nature 2023;620:172–80.
-
Topol EJ. Gemini in clinical medicine. Nat Med 2024.
-
Yu K, et al. SynSUM: synthetic clinical data generation. 2024.
-
Bravata DM, McDonald KM, Smith WM, et al. Systematic review of surveillance systems. J Am Med Inform Assoc 2004;11(4):287–97.
-
Lund EM, Armstrong PJ, Kirk CA, et al. Health status and populations of pets. J Am Vet Med Assoc 1999.
-
Wagner MM, Tsui FC, Espino JU, et al. The emerging science of very early warning detection. BMJ 2006;333:689–92.
-
Mostashari F, Hartman J. Syndromic surveillance: a local perspective. J Urban Health 2003;80:i1–7.
-
Irwin P, et al. Syndromic surveillance in veterinary medicine. 2008.
-
Centers for Disease Control. Melamine pet food outbreak. 2007.
-
Davies H, et al. PetBERT-ICD: outbreak detection. 2024.
-
Blei DM, Ng AY, Jordan MI. Latent Dirichlet allocation. J Mach Learn Res 2003;3:993–1022.
-
Lazic S, et al. Topic modeling in clinical text. 2021.
-
Davies H, et al. LDA on SAVSNET records. 2024.
-
Grootendorst M. BERTopic: neural topic modeling. 2022.
-
Davies H, et al. BERTopic on 1 million dog records. 2025.
-
Narayanan A, Felten E, Mackenzie J, et al. Risks from identified records. Nature 2022;608:37–46.
-
El Emam K, Rodgers S, Malin B. Anonymising and sharing individual patient data. BMJ 2015;350:h1139.
-
Neamatullah I, Rothrey MM, Lehto J, et al. Automated de-identification of clinical notes. J Am Med Inform Assoc 2008;15:328–35.
-
Liu Y, et al. De-identification of clinical notes. J Am Med Inform Assoc 2019.
-
Johnson AEW, et al. De-identification of free-text clinical notes. 2020.
-
Entwistle P, et al. Deep learning de-identification. 2021.
-
Antes L, et al. Generalizability of de-identification models. 2022.
-
Dernoncourt F, Lee J, Uzuner O, et al. De-identification of patient notes with recurrent neural networks. J Am Med Inform Assoc 2017;24:596–606.
-
Lerner B, et al. HuggingFace de-identification. 2023.
-
Majumder S, et al. Preserving patient privacy. 2023.
-
Johnson AEW, et al. Generalization gap in NLP de-identification. 2022.
-
SynthEHR: synthetic EHR generation. 2021.
-
Gonzalez-Hernandez G, et al. Synthetic clinical text. 2022.
-
Shumailov I, et al. AI models collapse when trained on recursively generated data. Nature 2023;621:751–9.
-
Chen M, et al. Limitations of synthetic data validation. 2024.
-
Johnson AEW, Bulgarelli L, Shen L, et al. MIMIC-IV. Sci Data 2023;10:600.
-
Goldberger AL, et al. MIMIC. 2000.
-
Davies H, et al. PetEVAL: open evaluation dataset. 2025.
-
Patterson D, Gonzalez J, Quinones Q, et al. Carbon emissions and large neural networks. 2021.
-
Schwartz R, Dodge J, Smith NA, et al. Green AI. Commun ACM 2019;63:54–62.
-
Li P, Yang Y, Islam M, et al. Making AI less water-intensive. 2024.
-
Frantar E, et al. Small language models. 2024.
-
Bender E, Gebru T, McMillan-Major A, et al. On the dangers of stochastic parrots. FAccT 2021.
-
Snell J, et al. CPU-efficient NLP. 2023.