语言模型在兽医临床实践中的应用:风险与实用指南

语言模型在兽医临床实践中的应用:风险与实用指南
Nathan Bollig, DVM, MS, Jonathan L. Lustgarten, MS, PhD, VMD, CSPO, Elizabeth Venit, VMD, MPH
关键词
- 人工智能
- 大语言模型
- 自然语言处理
- 临床决策支持
- 负责任的人工智能
- 兽医中的人工智能
要点
- 大语言模型可辅助客户沟通、病历文书书写、临床决策支持和临床实践审查。
- 其优势必须与准确性、数据隐私与安全、偏见引入和临床技能退化等风险相权衡。
- 使用任何人工智能工具时,兽医必须确保持续遵守所在司法管辖区的法规,获得客户适当的知情同意,并保持问责制、透明度和人工监督。
引言
能够解释或生成语言的计算机系统正越来越多地应用于兽医和人类医疗保健领域,用于客户沟通、病历文书书写、临床决策支持(clinical decision support, CDS)和实践审查。然而,这些工具引发了对数据安全、知情同意、透明度、偏见缓解、幻觉风险以及持续人工监督必要性的担忧。具体工具需要额外的预防措施和审慎使用的考量。本文综述了利用人工智能(artificial intelligence, AI)语言模型进行语言生成、以支持兽医临床实践的各类工具,并就每种应用的潜在风险、注意事项和建议进行阐述。
背景
语言模型简介
由计算机进行语言处理或生成称为自然语言处理(natural language processing, NLP),而表示或处理语言的基础技术称为语言模型[1]。早期的 NLP 系统采用符号文法表示语言,主要依赖预定义规则来模拟语言理解[2–4];自20世纪80年代末以来,方法已从预定义规则转向统计方法,如机器学习——即通过从文本数据集(即语料库)中学习来模拟语言理解[5–7]。此后,语言模型随计算能力和大型文本数据集获取的稳步增长而协同演进[8,9]。
当前的 NLP 模型主要基于神经网络,其结构类似生物神经元。每个单元(如神经元)整合来自前序单元的信息,转换数据,并将修改后的信号传递给后续单元,直到输入被转换为最终输出[10,11]。
神经网络的架构描述了网络中各单元之间的连接方式,并决定信息如何流经模型以及如何被模型表示。神经网络通常组织成若干"层",信息依次从一层流向另一层。可以说,语言建模领域最重大的创新是那些扩展了模型可表示信息范围的新架构。Vaswani 及其同事于2017年发表的 Transformer 架构是推动 AI 语言模型普及的重要驱动力[12]。本文聚焦生成式语言模型,即输出为语言的模型,其中许多采用 Transformer 架构[13–15]。
大语言模型
大语言模型(large language model, LLM)是规模相对较大的深度神经网络,如今大致指具有至少1000亿个模型参数(即单元之间连接)的模型[16]。如此规模使得该技术在很大程度上依赖运营数据中心并通过互联网平台提供 LLM 服务的公司[17]。
LLM 基于数十亿或数万亿词的文本进行训练,目标单一:根据上下文词汇预测句子中的下一个词(图1A)。这种训练可以大规模进行——在训练语料库中隐藏词汇,让模型根据上下文文本预测缺失的词,最终创建出能够模拟广义、多模态语言理解的模型[18]。通常,用户或软件程序通过提交称为提示词(prompt)的文本查询与 LLM 交互,并接收 LLM 的文本回复。提示词流经大型神经网络,回复中的每个词根据模型对序列中下一个最可能出现的词的概率预测来选择。LLM 输出在进一步操作前由人工审阅的工作流程称为人在回路(human in the loop)(图1B)。虽然用户可能直接与商业 LLM 平台交互,但他们越来越多地通过第三方软件间接使用 LLM——这些软件收集数据、构建提示词,并将查询发送到商业托管的 LLM 服务(图1C)。
幻觉
临床医生应认识到,LLM 只是通过统计建模来模拟语言理解。这一过程也可能因错误的训练信息而产生偏见[19],从而引发对其在医疗环境中应用有效性的担忧[20]。
LLM 产生的错误、无意义或有害结果称为幻觉(hallucination)。幻觉有多种不同类型,包括事实错误、事实虚构、上下文不一致、逻辑不一致和指令不一致[21]。表1列出了 LLM 在生成兽医主观、客观、评估和计划(Subjective, Objective, Assessment, and Plan, SOAP)病历记录时可能产生的幻觉示例。
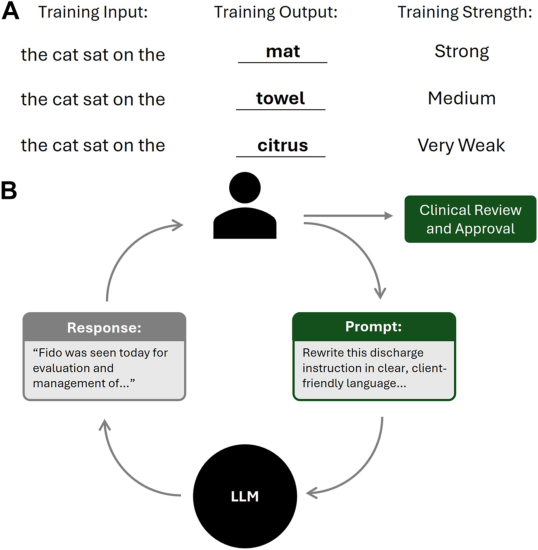
图1. 大语言模型(LLM)。(A) LLM 被训练用于根据上下文文本(训练输入)预测句子中的下一个词或缺失词(训练输出)。自然文本被用于构建这些训练实例,提供了反映各种语境中词汇用法的大规模训练集(训练强度)。(B) 用户通过提交提示词并接收模型的文本回复与 LLM 交互,构成人在回路的 AI 系统。(C) 用户可通过第三方应用与 LLM 交互,这些应用通过互联网提交包含医疗细节的提示词。(D) 用户与 LLM 之间的交互可由执行附加功能(如检索增强生成)的软件管理。该软件检索额外信息(如病历、公共数据库)并将其添加到 LLM 提示词中。
讨论
本节综述语言模型的4种常见应用:客户沟通、病历记录、临床决策支持和临床实践审查。随后是通用的专业伦理指导。在兽医临床实践中使用 AI 语言模型的建议汇总于表2。
客户沟通
起草沟通内容
LLM 通常被用于起草和审阅沟通内容,如就诊后摘要、出院指导、电子邮件和预约提醒,基于提供的临床背景信息[30,31]。它们可以建议更清晰、更具同理心或更简洁的客户沟通措辞[30]。然而,幻觉风险要求谨慎监督[32]。由于关于兽医专用 LLM 性能、错误特征和安全护栏的已发表证据有限,其在实践中的可靠性尚无法完全评估。
自动回复与聊天机器人
近年来,AI 驱动的聊天机器人已被部署用于回答常规客户问题和协助预约安排[30,33]。在某些场景下,这些先进系统通过引导宠物主人完成结构化问题路径来进行初步症状分诊[34]。虽然在兽医领域尚未广泛应用,但在人类医学中,患者可以在接受医疗前与自动化系统或聊天机器人交互[35]。在兽医领域,关于 AI 聊天机器人的已发表研究和公开评估有限。尽管准确性证据相对不足,这些工具仍被营销为面向兽医消费者的应用,用户可以就上传的兽医记录提出复杂问题。
注意事项与建议
LLM 应用提高了效率和可及性,但也带来风险。虽然病情摘要和出院指导最需要仔细审查,但 LLM 可能在任何沟通中引入错误。用户必须审阅所有面向客户的沟通内容。用户应考虑错误、不当语气或被误解的语言风格对客户关系的影响。聊天机器人可能提供不完整或不准确的信息、过度简化复杂病情,或提供过时信息[36]。如果聊天机器人提供的信息与兽医的判断相矛盾,可能导致冲突或客户对兽医专业判断信任的丧失[36]。
病历记录
记录摘要
由于大多数兽医记录是非结构化的,且计费编码不一致,利用 NLP 和 LLM 从临床数据中提取结构化洞察的兴趣日益增长[37,38]。LLM 可以提炼和总结复杂的病历记录和非结构化临床叙述,输出为摘要或关键数据点等结构化内容[39]。该技术的一个常见用途是总结转诊记录或其他诊所的病历。然而,多项研究表明性能可能存在差异,需要监督和审阅[39,40]。另一项研究表明,ChatGPT 能从自由文本记录中高精度识别超重体况评分[41]。越来越多的证据表明,LLM 可能能够从病历中识别诊断、治疗和结局[42,43]。尽管 LLM 在此类用途中的应用日益增多,但除这些特定用例外,关于其准确性和幻觉率的已发表信息很少。
AI 文书助手
语音转文本系统越来越多地被用于转录兽医笔记或填充模板,尤其是在放射科,使用经过语音训练或兽医专用的语言模型[44]。然而,性能因麦克风质量、录音环境和环境噪音而异。虽然单向麦克风和降噪等专用硬件可以提高准确性,但缺乏标准化基准测试阻碍了最佳实践的确立。
环境麦克风通过录制自然的兽医—客户对话扩展了该技术。虽然具有挑战性——需要准确的说话人区分、噪音过滤和严格遵守隐私协议——但早期采用者报告了显著益处,包括减少文书负担和信息遗漏[44–48]。
病历生成
如今许多 LLM 系统可以接收文本或音频输入并将其转换为病历记录。常见方法是使用 AI 文书助手创建体格检查记录或 SOAP 病历。然而,也可以使用此类工具起草操作记录或诊断报告,如病理或放射报告。一项已发表的演示展示了对犬沙丁胺醇中毒场景的准确摘要和计划生成[32]。这些系统使用微调、提示工程和 RAG 的不同组合来起草病历记录,其中一些整合了来自精选兽医数据库的决策支持内容[46,47]。其准确性和幻觉率取决于输入的清晰度、所使用模板的上下文和细节,以及可用以支撑 LLM 回复基于事实信息的数据[45,48–50]。幻觉风险仍然是一个重要问题,尤其是在 SOAP 病历的评估和计划部分,因为这些部分具有直接的临床意义[51]。
注意事项与建议
虽然这些用途可以减少阅读和书写病历的时间,但其输出仍必须经过审阅、编辑以确保准确性和完整性,并经批准;兽医是病历记录的最终医疗和法律权威。必须告知客户任何环境监听工具的存在,并提供选择退出的选项。在采用 LLM 工具之前,兽医管理者应向开发者询问模型如何训练和更新,以及如何更改病历书写风格或模板。
LLM 辅助病历中可能在多个步骤出现错误。环境监听系统可能遗漏未口述的关键细节;如果未纠正,AI 设备在既往输出基础上构建时,错误可能影响后续输出。转录准确性可能因所用模型而异[52]。LLM 可能产生导致病历过于冗长或不准确的输出,必须进行修改或纠正。此外,如果系统无法访问患者的完整病史,患者特定的上下文可能丢失[53],增加偏见和产生不准确或不当建议的风险。
各管理委员会对于用于创建转录的录音是否也被视为病历的一部分可能有不同裁定。如果是,则录音应与书面记录一样遵守相同的数据保留政策。因此,兽医管理者应确保持续遵守各委员会的要求。AI 系统还应在未经明确同意的情况下禁用语音数据保留功能。
| 客户沟通 | • 应用免责声明,明确标注 AI 生成内容 • 使用 AI 起草沟通内容而非直接最终发送 • 不使用 AI 聊天机器人向客户提供实时医疗建议 • 确保所有 AI 生成内容经人工审阅 • 确保 AI 系统传输或存储的私人信息安全 |
| 病历记录 | • 要求主治临床医生在将所有 AI 生成材料纳入病历前进行审阅 • 定期审计 AI 工具输出的准确性和语气(如推断诊断、评论性文字) • 口头叙述体格检查发现和关键临床信息,以确保准确记录 • 根据适用法规和客户同意决定是否保留录音 • 确保 AI 系统传输或存储的私人信息安全 • 根据应用风险等级和所有适用法律建立知情同意 |
| 临床决策支持(CDS) | • 使用 AI 工具增强而非替代临床医生的专业判断,并仔细审阅所有输出 • 在病历中记录使用 AI 决策支持工具的情况 • 避免使用 CDS 工具创建初稿;而是用其评估和/或补充临床医生起草的内容 • 使用在与目标物种和执业范围相关的兽医数据上训练和验证的应用 • 提前制定解决 AI 建议与临床判断之间冲突的程序(如寻求独立临床医生意见) • 定期审计 AI 工具输出的准确性 • 确保 AI 系统传输或存储的私人信息安全 |
| 临床实践审查 | • 确保基于 AI的医疗提供者审查用于专业发展,而非监控 • 让临床和行政人员参与工具选择、配置和治理 • 向用户提供其本人结果的完全访问权 • 限制用户仅能访问自己的结果 • 要求人工审阅所有 AI 生成的结果,并在采取任何行动前补充人工反馈 • 不在薪酬或纪律处分决定中使用 AI 生成的评分 • 确保 AI 系统内传输或存储的私人信息安全 |
临床决策支持
文献检索与证据摘要
用于临床信息检索的 AI 系统通常使用 RAG 将语义搜索与受控兽医文献来源相结合[46,47]。当临床医生提出问题时,系统从教科书或期刊中检索相关段落,并使用 LLM 进行综合。由于回复受限于经审核的来源,幻觉率可能低于通用 LLM。可靠性取决于底层数据库和 RAG 方法的质量[54]。
AI 用于教育和诊断推理
较新的 LLM 在兽医考试中的表现有所改善,GPT-4 达到约77%的正确率,而 GPT-3.5 为55%,并且经常在鉴别诊断列表中包含正确的最终诊断[32]。人类医学中也观察到类似模式,导致培训人类临床医生越来越依赖 LLM 进行个性化教育[55]。尽管具有这种知识表示能力,LLM 缺乏真正的病理生理推理,并且仍然容易产生过度自信的错误输出,可能误导受训者。虽然通用模型性能在不断提高[56],但尚未有已发表的评估分析最新模型对兽医教育的影响。
注意事项与建议
CDS 工具是 LLM 在医学中风险最高的应用之一。风险包括幻觉、缺乏兽医特定场景的验证,以及兽医因丧失独立专业思考而导致的技能退化[52,57–59]。这些工具特别容易因训练数据不足或不匹配而产生隐性偏见[60]。LLM 在复杂场景或需要特殊同理心或伦理考量的场景中尤其困难[61],并可能抑制兽医与客户之间的共同决策过程。许多此类工具是为人类医学开发并调整用于兽医应用的,因此缺乏真实世界的验证。最后,目前尚无通用的基准数据来评估各工具在兽医领域的性能[62]。
这些风险可能最终导致兽医专业判断的退化,从而导致不达标的医疗服务。审慎的临床医生不会使用这些工具创建初稿,而是先完成思考过程,然后通过 CDS 工具运行病历以识别遗漏,如遗漏的鉴别诊断[52]。这些工具应被用于增强和支持兽医的专业判断,而非替代它。
医疗提供者与诊所层面审查
语言模型可以通过检测诊断频率、治疗选择或患者结局中的异常值,识别遗漏信息和偏离预期临床模式的情况[63–65]。LLM 还被用于评估临床试验对《临床试验报告统一标准》的依从性[66]。在兽医领域,应用主要集中在群体健康和流行病学,以识别疫情的早期指标[67–71]。类似方法可通过审查医疗提供者和整体诊所对标准的依从性来支持伴侣动物诊所的质量改进,但需要人类专业判断,因为统计异常可能反映病例组合差异而非实际质量问题。
注意事项与建议
对医疗提供者审查和教育的 AI 支持仍应审慎对待。例如,这些工具可能试图根据"舒适"沉默的时间等指标来评价医疗提供者的床边态度;虽然开发者可以用这些指标近似同理心反应[72],但 AI 无法完全理解所有细微差别。仅音频的 LLM 模型可能遗漏非语言线索,如面部表情和手势,这些传达的语气可能与纯声音不同。
这些工具也可用于评估医疗提供者的医学知识。然而,该应用极易受到偏见影响——既来自开发所用的训练数据,也来自开发者的潜在偏见。例如,如果训练数据偏向更先进、更昂贵的诊断选项,医疗提供者可能因推荐针对特定客户和患者场景的较简单但更个体化的治疗而受到惩罚。同样,AI 工具可能提供反映对最佳医疗的意外判断的回复,例如在数量与生活质量维度上[73]。
鉴于这些担忧,医疗提供者审查应用不应被表面价值所接受。必须有人类——最好是另一位兽医——在回路中提供对人际互动的可信评估。
专业与伦理指导
LLM 可以减少在客户沟通、病历创建和 CDS 等行政任务上花费的时间[74]。人类医生的研究表明,AI 行政辅助可能增加与患者相处的时间、提高诊断准确性,并通过减少文书负担来支持决策[52,75,76]。兽医可能获得类似的益处。
然而,兽医应权衡潜在优势与伦理和实际问题[77,78]。使用任何 AI 设备时,兽医必须确保持续遵守所在司法管辖区的法规,获得客户适当的知情同意,并保持问责制、透明度和人工监督。
数据安全与隐私
兽医必须确保遵守要求充分数据安全和保密的联邦及州/省法律法规[79]。这些法律适用于所有记录,包括纸质记录、电子医疗系统,以及所有工具的使用,包括 AI 应用。
在选择可能为病历生成内容的 AI 系统时,建议遵循若干最佳实践(框1)。必须仔细审查使用条款和隐私政策。虽然兽医缺乏统一的安全标准,但软件可以通过 SOC 2 或 ISO 27001 认证来证明对数据安全的承诺,这些认证涉及外部审计。当前兽医医疗领域的许多系统使用开放 AI 系统,可能使用提交的数据来重新训练其模型或评估系统性能。必须建立保障措施,防止数据在设备与外部方(如设备开发公司或开放 AI 系统)之间的不安全传输。如果数据要传输到第三方可访问的服务器或存储在其中,所有第三方应证明遵守数据隐私和安全标准,如匿名化和加密。数据安全法律法规在 AI 领域持续发展。AI 用户应确保对所在国家和司法管辖区适用法律有最新和准确的理解。
框1 临床使用生成式语言模型时数据安全与隐私的通用建议
数据安全与隐私建议 - 审查 AI 工具的使用条款和隐私政策 - 了解工具如何存储、传输和保护客户私人数据(如匿名化、加密) - 审查可用的安全认证(如 SOC 2、ISO 27001) - 制定诊所层面的 AI 政策,定义可接受的安全标准 - 监控访问控制、入侵检测和安全警报[53]
知情同意
知情同意是一项关键的法规要求,实现两个目标。第一是支持兽医对客户的伦理义务,确保在如何向患者提供医疗方面有理解和共识。第二更为实际:如果兽医使用 AI 设备导致民事诉讼或管理委员会投诉,记录和证明已获得客户知情同意可能有助于保护兽医。然而,这并不能免除兽医因专业判断失误应承担的责任。
目前,对于在兽医领域使用 AI 何时以及如何获得客户知情同意,尚无标准化指南,但应考虑若干因素(框2)。兽医必须运用专业判断来确定每种应用、每位客户和每位患者的适当同意等级。同意等级可能因应用风险而异。低风险行政用途(如预约提醒)可能不需要明确同意。对于 AI 文书助手和环境监听设备,在某些地区默示同意可能就足够(如张贴告示标明设备的使用和选择退出的选项);然而,建议兽医调查所在州关于双方同意录音的具体法律。较高风险的诊断或临床应用应告知客户使用该设备的风险和获益,并记录客户的同意[77]。应咨询现行法律、法规、政策和指南以确定预期的同意等级。
为获得知情同意,兽医应能够向客户提供关于设备如何得出输出结果的基本知识,并披露自身使用该工具的经验[80]。
框2 临床使用生成式语言模型时知情同意的通用建议
知情同意建议 - 根据工具的风险评估确定同意要求,包括数据安全、临床影响、临床医生对工具如何得出输出的了解程度、临床医生的接受度和适用法律 - 在可行时为客户提供 AI 工具的选择退出选项
可信度
偏见可能在模型开发过程中或由兽医自身引入 AI 设备。系统性能因模型开发方式及其训练数据是否准确代表目标临床人群而异[80]。训练方法和数据引入的偏见可能使兽医无法完全评估,从而给 AI 生成输出的可信度带来不确定性。偏见可能来自过度代表或代表不足某些物种、品种或病情的训练数据集,或来自未经兽医特定验证而用人类数据优化的模型。医学领域的研究表明,如果 AI 设备仅在一种社会经济人群上训练,可能引入偏见[60];如果用三级医院而非社区诊所的数据训练,可能表现出对偏好治疗方案的偏见。AI 系统开发者为减少训练集偏见所采用的解决方案包括数据集多样化、算法公平技术、偏见审计和评估指标、合成数据增强、部署后监测、利益相关者参与和伦理审查[52,60]。
自动化偏倚(automation bias)是指用户过度信任 AI 输出而绕过专业判断。这可能导致技能退化、作为或不作为的医疗差错、医疗质量下降,以及因错误输出未被纠正而导致的 AI 性能逐渐退化[57,81]。由于自动化偏倚基于人类行为,纠正它最关键的一步是认识到每个人都可能经历自动化偏倚。框3列出了通常会增加自动化偏倚可能性的因素。
鉴于影响 AI 系统可信度的挑战,包括偏见和幻觉,必须强调人工审阅所有 AI 生成输出的极端重要性[83]。
框3 与自动化偏倚相关的因素
增加自动化偏倚可能性的因素包括: - 任务难度增加和工作负荷加重 - 兽医经验不足 - AI 算法模糊性增加 - 对 AI 幻觉的可能性或危害性缺乏认识 - 训练数据中的偏见[57,82]
人在回路
无论是否使用语言模型,兽医都是所有与兽医执业相关的临床决策和行动的最终权威和最终责任方。每次使用 AI 工具时,在任何决策或行动之前,都应由人工积极审阅 AI 工具的输出。重要的是,该人工必须具备检测和纠正错误所需的专业知识。即使对于生成客户电子邮件或其他沟通内容等较低风险用途,本建议同样适用。
总结
本文综述了利用 AI 语言模型进行语言解释和生成、以支持兽医临床实践的计算机系统。LLM 是统计模型,在回应用户提供的提示词时模拟广义语言理解。
AI 工具可以在临床环境中提供有意义的益处,但由于伦理和实际考量,需要谨慎使用。本文提出了支持高质量结果的建议。兽医应审阅任何工具的最佳实践,例如,环境 AI 文书助手的结果可能因录音质量和发现的明确口述程度等因素而有很大差异。兽医应审慎审阅使用条款和隐私政策,根据风险等级和所有适用法律征求知情同意,认识自动化偏倚的人为驱动因素,并在病历中记录使用 CDS 工具的情况。
目前没有任何语言模型能够保证不产生错误、误导性或有害的输出;因此,所有 AI 生成的临床内容都应由经适当授权、有资格在无 AI 辅助下执行相同任务的兽医人员审阅。
临床要点
- 在临床中,LLM 已被用于支持客户沟通、病历转录和生成、CDS 和临床实践审查。
- 这些系统可能生成自信但错误或不当的内容,包括具有临床意义的错误;所有 AI 生成的材料在使用前必须由兽医审阅。
- 任何人都可能经历自动化偏倚,即过度信任自动化系统的倾向,尤其是在某些条件下,如工作负荷加重时。
- 使用任何 AI 工具时,兽医必须确保持续遵守所在司法管辖区的法规,获得客户适当的知情同意,并保持问责制和透明度。
- 无论是否有 AI 参与,兽医始终是所有临床决策和病历内容的最终医疗和法律权威。
写作过程中人工智能及人工智能辅助技术的声明
在准备本文的过程中,作者使用了 OpenAI 的 GPT-5.2 和 Anthropic 的 Claude Sonnet 4.6 来分析和批评起草的文字。使用该工具后,作者审阅和编辑了文章文字,并对出版物的内容承担全部责任。
利益冲突声明
作者声明无经济利益冲突。
参考文献
-
Eisenstein J. Introduction to natural language processing. Cambridge (MA): MIT Press; 2019.
-
Chomsky N. Three models for the description of language. IEEE Trans Inf Theor 1956;2(3):113–24.
-
Hutchins WJ. The Georgetown-IBM experiment demonstrated in January 1954. In: Frederking RE, Taylor KB, editors. Machine translation: from real users to research. Berlin, Heidelberg: Springer; 2004. p. 102–14.
-
Rajaraman V. From ELIZA to ChatGPT. Resonance 2023;28(6):889–905.
-
Manning C, Schütze H. Foundations of statistical natural language processing. Cambridge (MA): MIT Press; 1999.
-
Berger AL, Brown PF, Della Pietra SA, et al. The candide system for machine translation. Plainsboro (NJ): Association for Computational Linguistics; 1994. p. 157–62.
-
Brown PF, Della Pietra VJ, Della Pietra SA, et al. The mathematics of statistical machine translation: parameter estimation. Comput Linguist 1993;19(2):263–311.
-
Mack CA. Fifty years of moore's law. IEEE Trans Semicond Manuf 2011;24(2):202–7.
-
De Luzi F. History of large language models. In: De Luzi F, Monti F, Mecella M, editors. Engineering information systems with large language models. Nature Switzerland: Springer; 2025. p. 13–31.
-
Krogh A. What are artificial neural networks? Nat Biotechnol 2008;26(2):195–7.
-
Mitchell TM. Machine learning. New York (NY): WCB/McGraw-Hill; 1997. p. 414.
-
Vaswani A, Shazeer N, Parmar N, et al. Attention is all you need. presented at: 31st international conference on neural information processing systems. 2017. Long Beach, (CA).
-
Feuerriegel S, Hartmann J, Janiesch C, et al. Generative AI. Business & Information Systems Engineering 2024;66(1):111–26.
-
Nah F-H, Zheng R, Cai J, et al. Generative AI and ChatGPT: applications, challenges, and AI-human collaboration. Journal of Information Technology Case and Application Research 2023;25(3):277–304.
-
Bengesi S, El-Sayed H, Sarker MK, et al. Advancements in generative AI: a comprehensive review of GANs, GPT, autoencoders, diffusion model, and transformers. IEEE Access 2024;12:69812–37.
-
Naveed H, Khan AU, Qiu S, et al. A comprehensive overview of large language models. ACM Trans Intell Syst Technol 2025;16(5):106–72.
-
Luitse D, Denkena W. The great transformer: examining the role of large language models in the political economy of AI. Big Data & Society 2021;8(2).
-
Wang T, Roberts A, Hesslow D, et al. What language model architecture and pretraining objective works best for zero-shot generalization? 2022:22964–22984.
-
Cross JL, Choma MA, Onofrey JA. Bias in medical AI: implications for clinical decision-making. PLOS Digit Health 2024;3(11):e0000651.
-
Sallam M. ChatGPT utility in healthcare education, research, and practice. Healthcare 2023;11(6):887.
-
Huang L, Yu W, Ma W, et al. A survey on hallucination in large language models. ACM Trans Inf Syst 2025;43(2):42–55.
-
Zhang S, Dong L, Li X, et al. Instruction tuning for large language models: a survey. ACM Comput Surv 2025;58(7):1–36.
-
Hu Z, Wang L, Lan Y, et al. LLM-Adapters: an adapter family for parameter-efficient fine-tuning of large language models. 2023:5254–5276.
-
Guu K, Lee K, Tung Z, et al. Retrieval augmented language model pre-training. 2020:3929–3938.
-
Lewis P, Perez E, Piktus A, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. 2020.
-
Sahoo P, Singh AK, Saha S, et al. A systematic survey of prompt engineering in large language models: techniques and applications. 2024.
-
Brown T, Mann B, Ryder N, et al. Language models are few-shot learners. Adv Neural Inf Process Syst 2020;33:1877–901.
-
Wei J, Wang X, Schuurmans D, et al. Chain-of-thought prompting elicits reasoning in large language models. Adv Neural Inf Process Syst 2022;35:24824–37.
-
Tonmoy SMTI, Zaman SMM, Jain V, et al. A comprehensive survey of hallucination mitigation techniques in large language models. 2024.
-
Tancredi W. The role of artificial intelligence chatbots in veterinary medicine. Today's veterinary practice. Gainesville (FL): North American Veterinary Community; 2023. p. 12–4.
-
Rumple S. Using ChatGPT to create efficiencies in your veterinary practice. IDEXX. 2025.
-
Chu CP. ChatGPT in veterinary medicine: a practical guidance of generative artificial intelligence in clinics, education, and research. Front Vet Sci 2024;11:1395934.
-
Angela Beal D. The power of AI in veterinary client communication. 2025.
-
Thompsett L. How Vet-AI is revolutionising pet care through prevention. InsurTech digital. 2025.
-
Guo J, Ma J. Enhancing intelligent triage with large language models: a comprehensive evaluation and optimization study. Annu Int Conf IEEE Eng Med Biol Soc 2025;2025:1–6.
-
Pal A, Wangmo T, Bharadia T, et al. Generative AI/LLMs for plain language medical information for patients, caregivers and general public: opportunities, risks and ethics. Patient Prefer Adherence 2025;19.
-
Lustgarten JL, Zehnder A, Shipman W, et al. Veterinary informatics: forging the future between veterinary medicine, human medicine, and one health initiatives. JAMIA Open 2020;3(2):306–17.
-
Trice C, Donnelly AL, Ackerman L, et al. Medical management considerations. In: Ackerman L, editor. Pet-Specific Care for the Veterinary Team. 2021.
-
Wulcan JM, Jacques KL, Lee MA, et al. Classification performance and reproducibility of GPT-4 omni for information extraction from veterinary electronic health records. Front Vet Sci 2024;11:1490030.
-
Shroff H, Shankar A, Baron A, et al. A large language model assistant for summarizing hepatology referral documents. Am J Gastroenterol 2026.
-
Fins IS, Davies H, Farrell S, et al. Evaluating ChatGPT text mining of clinical records for companion animal obesity monitoring. Vet Rec 2024;194(3):e3669.
-
Shah SV. Accuracy, consistency, and hallucination of large language models when analyzing unstructured clinical notes. JAMA Netw Open 2024;7(8).
-
Jiang Y, Irvin JA, Ng AY, et al. VetLLM: large language model for predicting diagnosis from veterinary notes. Pac Symp Biocomput 2024;29:120–33.
-
Walker S. Using veterinary dictation software: benefits and challenges. 2024.
-
Palm E, Manikantan A, Mahal H, et al. Assessing the quality of AI-generated clinical notes: validated evaluation of a large language model ambient scribe. Front Artif Intell 2025;8:1691499.
-
DVM360Staff. Two companies are integrating AI-based tools for enhanced SOAP notes. DVM 360. 2025.
-
CoVet launches consult CoVet featuring LifeLearn sofie AI integration. CoVet; 2025.
-
Ma SP, Liang AS, Shah SJ, et al. Ambient artificial intelligence scribes: utilization and impact on documentation time. J Am Med Inform Assoc 2025;32(2):381–5.
-
Olson KD, Meeker D, Troup M, et al. Use of ambient AI scribes to reduce administrative burden and professional burnout. JAMA Netw Open 2025;8(10):e2534976.
-
Shah SJ, Devon-Sand A, Ma SP, et al. Ambient artificial intelligence scribes: physician burnout and perspectives on usability and documentation burden. J Am Med Inform Assoc 2025;32(2):375–80.
-
Hatem R, Simmons B, Thornton JE. A call to address AI "Hallucinations" and how healthcare professionals can mitigate their risks. Cureus 2023;15(9):e44720.
-
Rabbani SA, El-Tanani M, Sharma S, et al. Generative artificial intelligence in healthcare: applications, implementation challenges, and future directions. BioMedInformatics 2025;5(3).
-
Fareed M, Fatima M, Uddin J, et al. A systematic review of ethical considerations of large language models in healthcare and medicine. Front Digit Health 2025;7.
-
Xu S, Yan Z, Dai C, et al. MEGA-RAG: a retrieval-augmented generation framework. Front Public Health 2025;13.
-
Zhui L, Yhap N, Liping L, et al. Impact of large language models on medical education and teaching adaptations. JMIR Med Inform 2024;12:e55933.
-
Zorpette G. Large language models are improving exponentially. IEEE Spectrum 2025.
-
Sujan M, Furniss D, Grundy K, et al. Human factors challenges for the safe use of artificial intelligence in patient care. BMJ Health & Care Informatics 2019;26(1).
-
Coghlan S, Quinn T. Ethics of using artificial intelligence (AI) in veterinary medicine. AI Soc 2024;39(5):2337–48.
-
Appleby RB, Basran PS. Artificial intelligence in veterinary medicine. J Am Vet Med Assoc 2022;260(8):819–24.
-
Levartovsky A, Omar M, Nadkarni GN, et al. Sociodemographic bias in large language model–assisted gastroenterology. JAMA Netw Open 2025;8(9).
-
Li J, Zhou Z, Lyu H, et al. Large language models-powered clinical decision support: enhancing or replacing human expertise? Intelligent Medicine 2025;5(1).
-
Bouchemla F, Akchurin SV, Akchurina IV, et al. Artificial intelligence feasibility in veterinary medicine: a systematic review. Vet World 2023;16(10):2143–9.
-
Zhou X, Cohen E, Zhou X, et al. Leveraging LLM to identify missed information in patient-physician communication: improving healthcare service quality. Front Med (Lausanne) 2025;12:1631565.
-
Abacha AB, Yim W-W, Fu Y, et al. MEDEC: a benchmark for medical error detection and correction in clinical notes. presented at: findings of the Association for computational linguistics. Vienna, Austria: ACL; 2025.
-
Boussina A, Krishnamoorthy R, Quintero K, et al. Large language models for more efficient reporting of hospital quality measures. NEJM AI 2024;1(11).
-
Srinivasan A, Berkowitz J, Friedrich NA, et al. Large language model analysis of reporting quality of randomized clinical trial articles: a systematic review. JAMA Netw Open 2025;8(8):e2529418.
-
Davies H, Nenadic G, Alfattni G, et al. Text mining for disease surveillance in veterinary clinical data: part one, the language of veterinary clinical records and searching for words. Front Vet Sci 2024;11:1352239.
-
Davies H, Nenadic G, Alfattni G, et al. Text mining for disease surveillance in veterinary clinical data: part two, training computers to identify features in clinical text. Front Vet Sci 2024;11:1352726.
-
Mukherjee D, Sagar K, Kobialka RM, et al. Filling the gap: artificial intelligence-driven one health integration to strengthen pandemic preparedness in resource-limited settings. Front Public Health 2025;13:1707306.
-
Lagua EB, Mun HS, Ampode KMB, et al. Artificial intelligence for automatic monitoring of respiratory health conditions in smart swine farming. Animals (Basel) 2023;13(11).
-
Wen H, Shi H, Yu J, et al. An intelligent diagnostic method for porcine gastrointestinal infectious diseases based on multimodal AI and large language model. Front Vet Sci 2025;12:1660745.
-
Bedmutha MS, Bascom E, Sladek KR, et al. Artificial intelligence-generated feedback on social signals in patient-provider communication: technical performance, feedback usability, and impact. JAMIA Open 2024;7(4):ooae106.
-
Zohny H, Allen JW, Wilkinson D, et al. Which AI doctor would you like to see? Emulating healthcare provider-patient communication models with GPT-4: proof-of-concept and ethical exploration. J Med Ethics 2025.
-
Albergante L, O'Flynn C, Meyer GD. Artificial intelligence is beginning to create value for selected small animal veterinary applications while remaining immature for others. J Am Vet Med Assoc 2025;263(3).
-
Goh E. Large language model influence on diagnostic reasoning. JAMA Intern Med 2024;184(10):1138–45.
-
Tierney AA, Gayre G, Hoberman B, et al. Ambient artificial intelligence scribes to alleviate the burden of clinical documentation. NEJM Catalyst 2024;5(3).
-
American Association of Veterinary State Boards. Regulatory considerations of the use of artificial intelligence in veterinary medicine. 2025.
-
British Veterinary Association. BVA policy position on artificial intelligence in the veterinary profession. 2025.
-
Babcock SL, Pfeiffer C. Laws and regulations concerning the confidentiality of veterinarian-client communication. J Am Vet Med Assoc 2006;229(3):365–9.
-
Poore TJ, Pinard CJ, Shabbir A, et al. Context matters: comparison of commercial large language tools in veterinary medicine. 2025.
-
Abdelwanis M, Alarafati HK, Tammam MMS, et al. Exploring the risks of automation bias in healthcare artificial intelligence applications: a bowtie analysis. J Saf Sci Resil 2024;5(4).
-
Zhang J, Zhang ZM. Ethics and governance of trustworthy medical artificial intelligence. BMC Med Inf Decis Making 2023;23(1).
-
Magrabi F, Ammenwerth E, McNair JB, et al. Artificial intelligence in clinical decision support: challenges for evaluating AI and practical implications. Yearbook of Medical Informatics 2019;28(1):128–34.